En bref
- OpenAI présente GPT-6.1 Sol à son DevDay 2026, annoncé proche d’Astra pour un cinquième du prix 2
- Ollama exécute en local les modèles de décision Jev : oui ou non, choix, scores avec une probabilité par option 3
- Depthfirst recommande de considérer qu’un attaquant peut toujours sortir d’un conteneur 6
Les signaux
Modèles
GPT-6.1 Sol, proche d’Astra pour cinq fois moins cher
Produit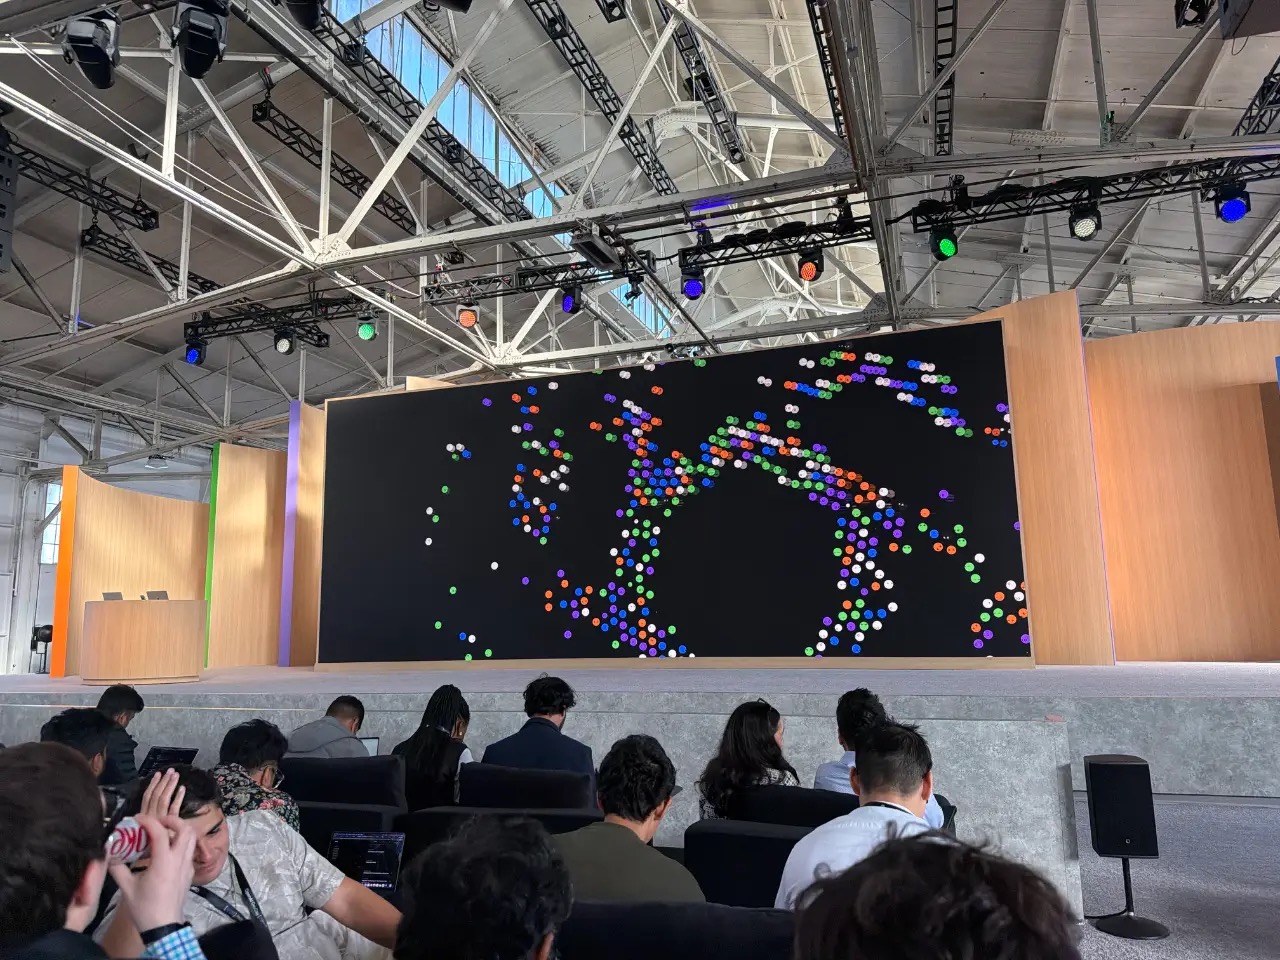
OpenAI a présenté GPT-6.1 Sol à son DevDay 2026. L’entreprise l’annonce proche du niveau d’Astra « pour un cinquième du prix » 2. Le tarif est de 2 dollars en entrée et 10 dollars en sortie, contre 10 et 50 dollars pour Astra 2. OpenAI a aussi lancé une Decisions API, qui répond en moins d’une seconde à partir d’options prédéfinies 2.
Outils
Ollama exécute des modèles de décision en local
Produit
Ollama supporte désormais les modèles de décision basés sur l’API Jev de TypeSafe 3. Ils répondent à des questions oui/non, des choix et des scores, avec une probabilité par option 3. Exécution à coût nul et latence basse 3.
Sécurité
l’isolation des conteneurs ne suffit plus
Opinion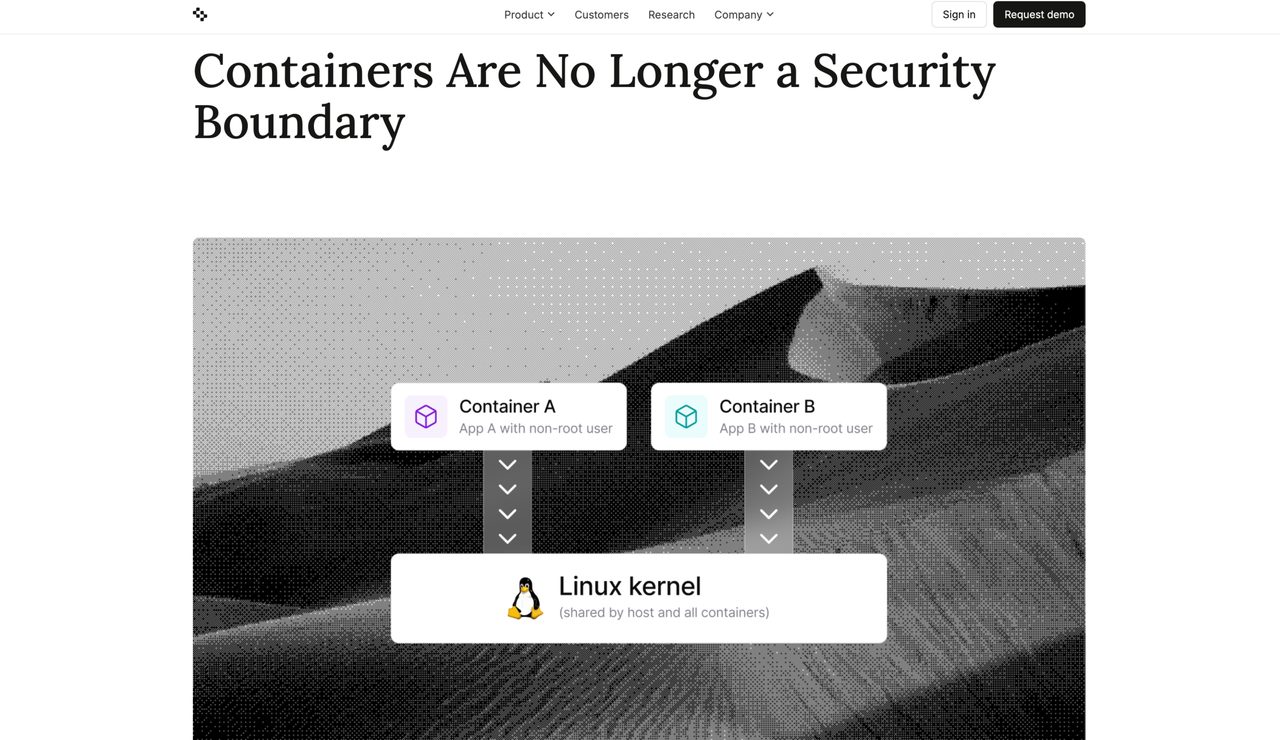
La société de sécurité Depthfirst recommande de considérer qu’un attaquant peut sortir d’un conteneur quand il le veut, car l’IA a fait baisser le coût d’une attaque 6. Sa parade : les microVM, qui réduisent la surface d’attaque sans l’annuler, puisque Firecracker repose encore sur KVM 6.
À retenir
- 5fois moins cher qu’Astra selon OpenAI : GPT-6.1 Sol coûte 2 dollars en entrée contre 10 2
- Coût nul, latence basse : modèles de décision Jev exécutables via Ollama, réponse avec probabilité par option 3
- Firecracker sur KVM : la microVM réduit la surface d’attaque mais ne l’annule pas 6
Niveaux de preuve
- Étude non relue par des pairs (1)Un article de recherche publié sans relecture par d'autres chercheurs.Fine-Tuning
- Produit (3)Une annonce ou une page de l'éditeur du produit.01 02 Matos
- Opinion (1)Un point de vue, pas un fait établi.03
Matos & Infra local
Sujet Matos/Infra : Nvidia veut placer une puce de surveillance à côté de chaque agent IA 16 Produit
Recommandation dev : Surveiller l’évolution de cette puce pour anticiper son intégration dans les racks d’inférence locaux 16.
Fine-Tuning & Quantiz
Technique / Outil : AutoDataBench, benchmark d’agents générant des données pour le fine-tuning supervisé et le RL 11 Étude non relue par des pairs
Apport : Aucun gain chiffré fourni ; le résumé indique que la production de tâches agentiques vérifiables repose encore sur du travail humain 11
Impact pratique : Évaluer la capacité d’un agent à écrire les données d’entraînement avant de l’intégrer à une boucle d’auto-amélioration 11
Sources (18)
Sources vérifiées le 30/09/2026 05:00 UTC · Notre méthode
| N° | Publication | Site | Date |
|---|---|---|---|
| 2 | OpenAI DevDay 2026 live blog | Simon Willison | 29 septembre 2026 |
| 3 | Ollama now supports Jev-style decision models | Ollama | 29 septembre 2026 |
| 6 | Conteneurs Linux - Quand l’isolation ne tient plus | Korben | 29 septembre 2026 |
| 11 | AutoDataBench: Can Agents Write the Data That Feeds the Self-Improvement Loop? | HF Papers | |
| 16 | Nvidia wants to put a watchdog chip next to every AI agent | Hacker News | 28 septembre 2026 |
Autres lectures (13)
Correction
Correction du 30 septembre 2026
la première version ouvrait sur Claude Sonnet 5.5, déjà traité la veille ; ce signal est remplacé par GPT-6.1 Sol. Nous avons aussi traduit les citations, ajouté le niveau de preuve de chaque information, et retiré deux rubriques en double ainsi que la vérification de prédiction déjà publiée le 28 septembre.
La rédaction de v3ille
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.