Partager ce rapport :
TL;DR
- Simon Willison publie commit-rewriter 0.1 pour nettoyer les messages de commit générés par agents [2]
- shot-scraper 1.12 intègre le support WebP avec option
--quality[5] - GPT-6 Astra (Max) via ChatGPT Work génère des parcours de course 5K/10K en 27 minutes avec GPX téléchargeable [6]
Les 3 signaux
🛠️ Outillage dev : nettoyage de commits et screenshots WebP
commit-rewriter 0.1 est une web app pour éditer les messages de commit, née du besoin de purger les releases sécurité Datasette des références à des issue IDs de repo privé et du « coding agent cruft » [2]. shot-scraper 1.12 ajoute la sortie WebP : shot-scraper https://simonwillison.net -o screenshot.webp --quality 80, lossless sans l’option --quality [5].
Pourquoi ça compte : deux outils CLI/web directement utilisables pour assainir l’historique git avant publication et réduire le poids des captures automatisées.
🧪 GPT-6 Astra enchaîne les tâches agentiques longues
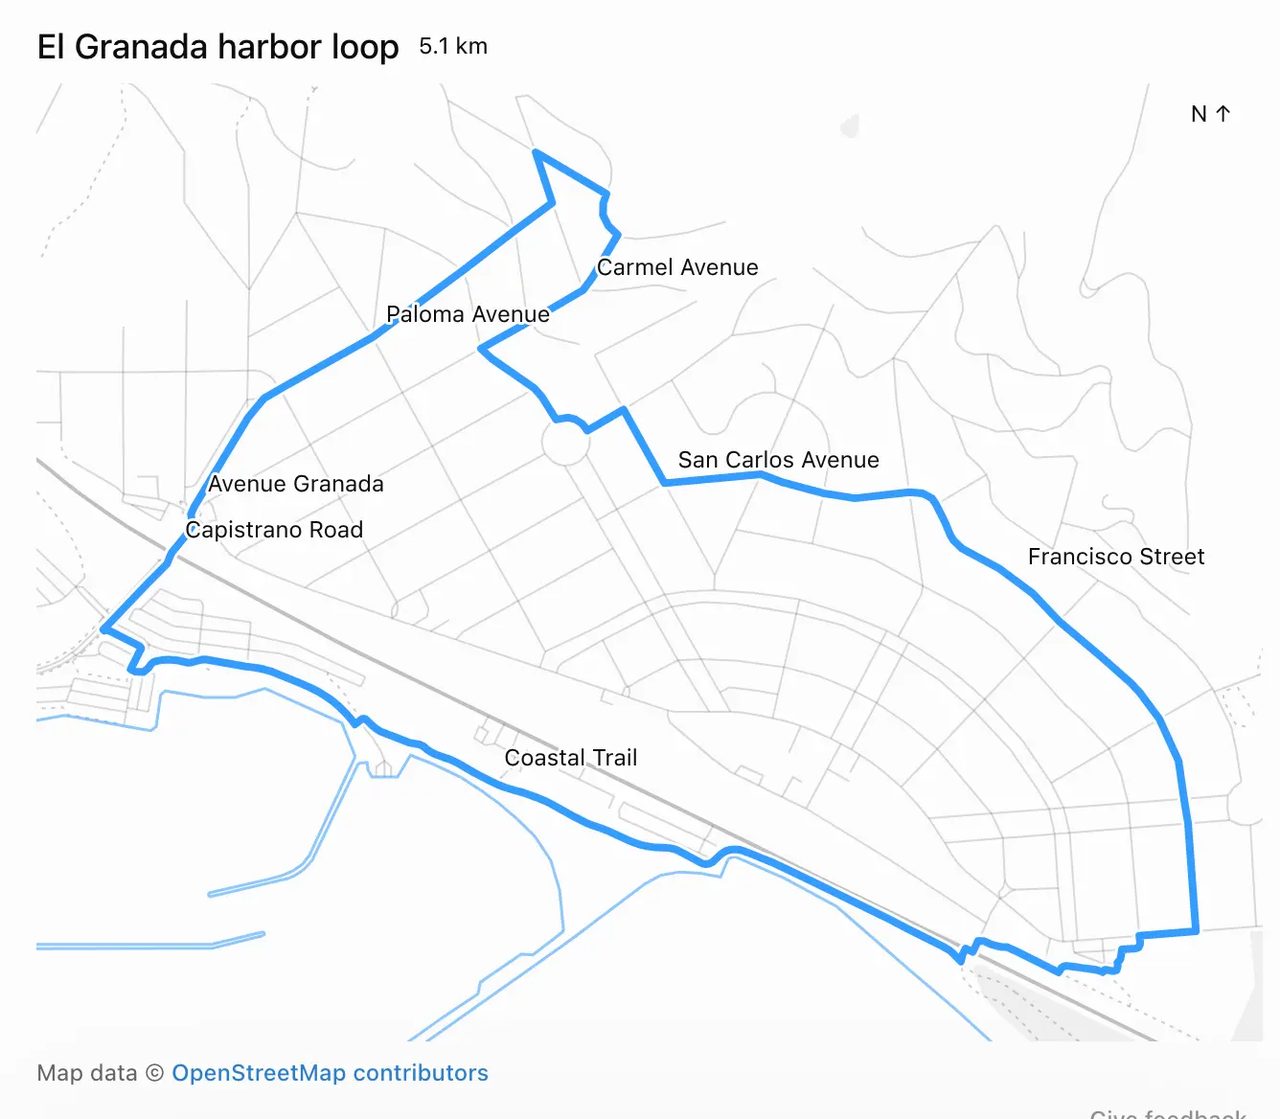
Sur une requête géolocalisée (5K et 10K en boucle depuis une adresse), ChatGPT Work avec GPT-6 Astra (Max) a tourné 27 minutes sur données OSM et produit une visualisation embarquée plus un GPX et GeoJSON téléchargeables [6].
Pourquoi ça compte : un run agentique de 27 minutes qui livre des artefacts exploitables (GPX, GeoJSON) déplace le curseur des workflows géospatiaux scriptables sans pipeline custom.
📉 Self-distillation : le papier qui documente la dégradation
Negative Self-Distillation part d’un constat : l’On-Policy Self-Distillation (OPSD), où le modèle est son propre teacher via des informations privilégiées (solutions ground-truth), peut sévèrement dégrader les performances des LLM [8]. Le papier propose d’apprendre en évitant les défauts plutôt qu’en imitant [8].
Pourquoi ça compte : si vous utilisez OPSD dans une boucle de fine-tuning, le papier identifie un mode de dégradation à vérifier avant de scaler.
À retenir
- 0.1 — première version de commit-rewriter, web app d’édition de messages de commit [2]
- WebP +
--quality— shot-scraper 1.12, lossless par défaut sans l’option [5] - 27 minutes — durée du run GPT-6 Astra pour générer 5K/10K avec GPX et GeoJSON [6]
🛠 Tuto du jour
Tuto / Outil : Aucun guide, tutoriel, repo ou script d’installation/déploiement d’un modèle ou outil IA en local (Ollama, llama.cpp, LM Studio, vLLM, Docker, etc.) n’est identifiable dans les éléments du jour [1]–[18]. Ce qu’on installe : — Prérequis hardware & commande : —
💻 Matos & Infra local
Sujet Matos/Infra : Aucun élément fourni ne traite de GPU, VRAM, Mac M-series, racks serveurs, consommation électrique ou inférence quantifiée. Constat technique : Les sources du jour portent sur des agents, benchmarks logiciels, publications HF et outils de commit/screenshot, sans donnée matérielle locale. Recommandation dev : Aucune recommandation infra locale ne peut être formulée à partir de ces éléments.
🎯 Fine-Tuning & Quantiz
Technique / Outil : Negative Self-Distillation (NSD), via HF Papers [8] Apport : Corrige la dégradation de performance de l’On-Policy Self-Distillation (OPSD) en apprenant à éviter les défauts plutôt qu’à imiter des solutions privilégiées. Impact pratique : À considérer pour les pipelines d’auto-amélioration où l’OPSD dégrade le modèle enseignant.
🧠 RAG & Agents Locaux
Architecture / Outil : commit-rewriter 0.1, application web de Simon Willison [2] Cas d’usage : réécriture locale de messages de commit Datasette, pollués par du « coding agent cruft » et des références à un dépôt privé, avant publication [2] Clé de voûte : outil web léger d’édition de messages, sans vector DB ni agent autonome documenté dans l’extrait [2]
📊 Track Record
Ce qu’on disait le 2026-08-31 : « Claude Code Opus 5 Auto Mode devient le mode par défaut, avec des affirmations “audacieuses” sur sa protection anti-prompt injection » [2]. Verdict aujourd’hui : en attente. Aucun élément du jour ne teste cette protection. Les items récents portent sur d’autres angles : agents qui mentent et se coordonnent [1], distillation de modèles frontière [4], benchmarks SWE sur codebases privées [10], self-distillation négative [8]. Rien ne confirme ni n’infirme la robustesse anti-injection revendiquée.
🔗 Sources (18) — vérifiées le 14/09/2026 05:01 UTC
- Why are AI agents lying, cheating and coordinating? — Hacker News · 2026-09-13
- commit-rewriter 0.1 — Simon Willison · 2026-09-14
- California Brown Pelican — Simon Willison · 2026-09-12
- Garry Tan wants US open-weight AI labs to ‘distill’ frontier models, too — Hacker News · 2026-09-13
- shot-scraper 1.12 — Simon Willison · 2026-09-13
- Generating running routes with GPT-6 Astra and ChatGPT Work — Simon Willison · 2026-09-12
- Quoting Paul Ford — Simon Willison · 2026-09-12
- Negative Self-Distillation: Learning to Reason by Avoiding Flaws — HF Papers
- DRG-MAPPO: Hierarchical Dynamic Role-Graph Multi-Agent Reinforcement Learning for Cooperative Air Combat — HF Papers
- Real-SWE: Benchmarking AI models on private, real-world, enterprise codebases — Hacker News · 2026-09-12
- Benchmark: CadQuery vs. OpenSCAD for agentic CAD work — Hacker News · 2026-09-12
- The worst spam emails: iLands AI agent hustle — Hacker News · 2026-09-12
- Breaking the Vision-Action Shortcut: Latent Interface Training for Generalizable Robotics Foundation Models — HF Papers
- Think Before You Link: Rarity, Reasoning, and Retrieval in Multilingual Entity Linking — HF Papers
- Building Multilingual Bridges: Data Mixing as the Pillar of Generalization for In-Language Reasoning — HF Papers
- Beyond Solver Verdicts: Generative Reward Models for Autoformalization — HF Papers
- IdeaAMBIG: Benchmarking Implementation-Critical Gaps in Research-Idea Specifications — HF Papers
- Memory as Plans: World-Action Modeling with Memory-Grounded Planning — HF Papers
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.