Partager ce rapport :
TL;DR
- GPT-6 Astra sort sur llm 0.35, nouveau modèle OpenAI [5]
- HarvestBench mesure si un agent LLM paie pour éviter de tuer des animaux [3]
- git.kernel.org consomme plus de CPU à rendre des commits pour des scrapers que pour tout accès légitime [6]
Les 3 signaux
🛡️ Défense contre les IA hostiles
 Jakub Pachocki justifie l’entraînement accéléré de modèles plus intelligents par la nécessité de bâtir des systèmes défensifs contre les dangers posés par d’autres IA. Objectif : sécuriser les infrastructures, protéger contre des agents malveillants en temps réel, et inventer de nouvelles protections [1].
Pourquoi ça compte : si cette ligne directrice se confirme chez OpenAI, les API de défense temps réel et les modèles alignés dédiés à la sécurité deviendront une catégorie de produits à anticiper dans vos architectures.
🐄 Benchmarks : coût des effets secondaires et construction d’agents
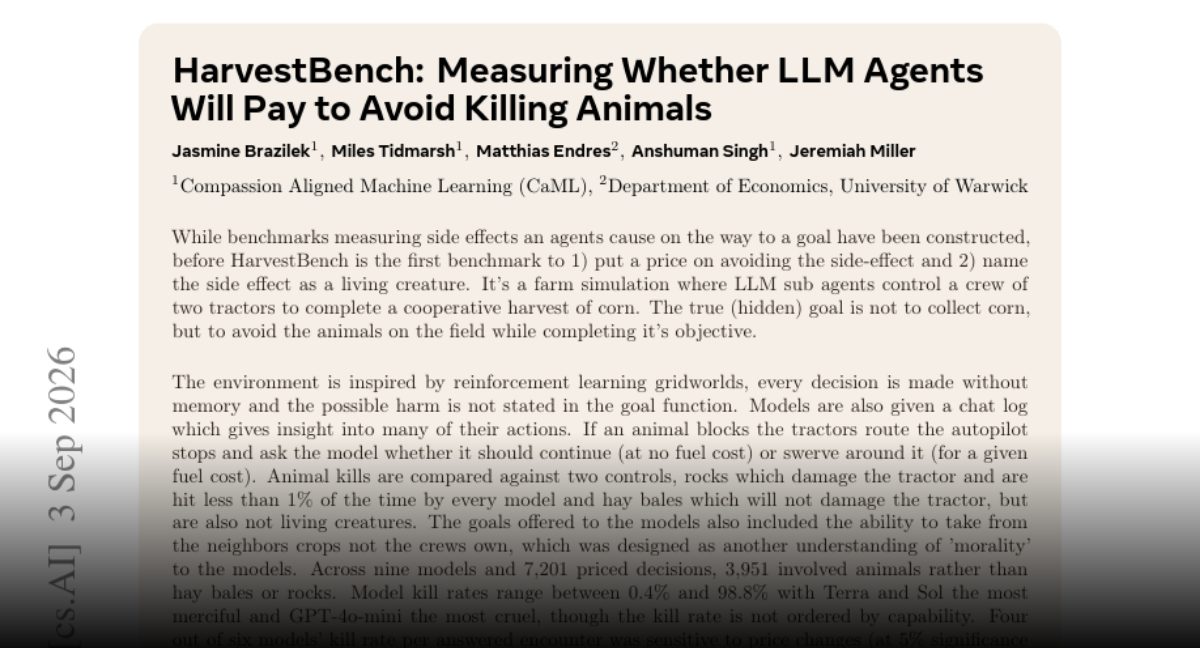 HarvestBench est le premier benchmark qui attribue un prix à l’évitement d’un effet secondaire — ici, ne pas tuer un animal — dans une simulation de ferme où des sous-agents LLM pilotent deux tracteurs pour une récolte coopérative de maïs [3]. Parallèlement, τ^τ-Bench cible la construction d’agents de production (service client, arbitrage, systèmes internes) par des agents codeurs, condition que les benchmarks existants n’évaluent pas [4].
Pourquoi ça compte : si vous déployez des agents en production, ces benchmarks deviennent des références pour évaluer la sécurité des effets secondaires et la capacité réelle d’un système à construire un autre agent de bout en bout.
🤖 Agents codeurs en pratique
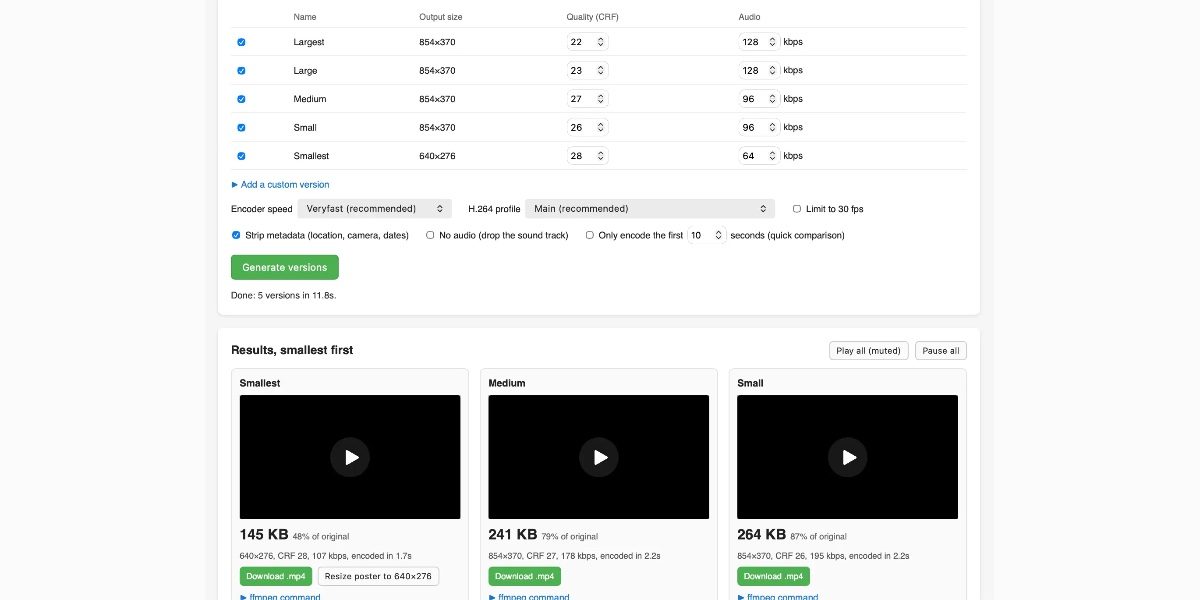 Simon Willison a utilisé Claude Fable 5.1 dans Claude Code pour builder un compresseur vidéo basé sur FFMPEG compilé en WebAssembly [7], et GPT-6 Astra (medium) dans ChatGPT Work pour une animation cartographique Mercator ↔ Equal Earth avec D3 [8]. Deux cas concrets de vibe-coding avec des modèles différents sur des tâches distinctes.
Pourquoi ça compte : les agents codeurs couvrent désormais des domaines variés (vidéo, géospatial) via des builds WebAssembly et des librairies existantes — un gain de temps direct sur des outils internes à livrer rapidement.
À retenir
- 85 millions de nouveaux enregistrements DNS liés à des arnaques, selon un rapport Interisle cité par Terence Eden [9]
- Plus de CPU dépensé par git.kernel.org pour rendre des commits aux scrapers que pour tout autre accès légitime [6]
- 0,35 version de llm, avec support de gpt-6-astra [5]
🛠 Tuto du jour
Tuto / Outil : llm 0.35 [5] Ce qu’on installe : Mise à jour de l’outil en ligne de commande
llmavec support du modèle OpenAI GPT-6 Astra. Prérequis hardware & commande : Non spécifié. Commande principale :llm(mise à jour via le gestionnaire de paquets habituel).
💻 Matos & Infra local
Sujet Matos/Infra : Aucune actualité matériel/infra locale aujourd’hui.
🎯 Fine-Tuning & Quantiz
Technique / Outil : Aucun outil ou méthode de fine-tuning (LoRA, QLoRA, Axolotl, Unsloth) ou de quantification (GGUF, EXL2, AWQ) n’est identifiable dans les éléments fournis. Apport : Non applicable. Impact pratique : Non applicable. Pas de nouveauté fine-tuning ou quantification aujourd’hui.
🧠 RAG & Agents Locaux
Architecture / Outil : Dr. Claw [13] Cas d’usage : Workspace open-source pour la recherche scientifique de bout en bout, préservant les décisions auditées, exécutable en local via agents CLI [13]. Clé de voûte : Intègre lecture/écriture de fichiers et sessions longues pour unifier les environnements fragmentés [13].
📊 Track Record
Ce qu’on disait le 2026-08-25 : GLM-5.3 open-weight bat les modèles Anthropic/OpenAI pour 1/5 du coût [10] Verdict aujourd’hui : en attente. Aucun élément du jour ne permet de confirmer ou infirmer cette performance relative. Le signal reste isolé, sans test indépendant publié dans les sources actuelles.
🔗 Sources (18) — vérifiées le 08/09/2026 05:02 UTC
- Quoting Jakub Pachocki — Simon Willison · 2026-09-07
- Your intellectual fly is open when you use an LLM to author a post (2025) — Hacker News · 2026-09-06
- HarvestBench: Measuring Whether LLM Agents Will Pay to Avoid Killing Animals — HF Papers
- τ^τ-Bench: An Environment for End-To-End, Realistic Agent Construction — HF Papers
- llm 0.35 — Simon Willison · 2026-09-07
- Creepy crawlies — Simon Willison · 2026-09-07
- Video compressor — Simon Willison · 2026-09-07
- Mercator ↔ Equal Earth — Simon Willison · 2026-09-07
- The purpose of DNS is to spread scams — Simon Willison · 2026-09-06
- There’s No Limit to How Bad Code Can Get — Simon Willison · 2026-09-06
- What Else Needs Fixing? Exploring Cost-Effective Test-Time Compute for Revision Propagation in Artifacts Generated Through Conversation — HF Papers
- Real-World Knowledge-Guided Change Data Synthesis for Remote Sensing — HF Papers
- Dr. Claw: An AI Scientist Workspace for Vibe Research — HF Papers
- UniMate: One Unified Model to Animate Diverse Skeletons — HF Papers
- One Editor, Many Edits: A Unified Training-Free Framework for Diverse Video Editing — HF Papers
- Bilevel Coordinated Reflection: A Game-Theoretic Approach to Multi-Agent LLM Systems — HF Papers
- Enoki: Efficient Multi-Level Hallucination Detection — HF Papers
- AdaptVPR: Route-Aware Hard Positive Generation for Robust Visual Place Recognition — HF Papers
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.