Partager ce rapport :
TL;DR
- GPT-6 Astra présenté aux développeurs, excelle en modélisation 3D [11]
- MaxKernel génère des kernels pour accélérateurs via un système multi-agents avec feedback compilateur temps réel [3]
- Iris-mini et Iris-pro, agents de recherche entraînés à 35B-A3B et 397B-A17B, présentés avec leur pipeline de données [15]
Les 3 signaux
🎯 GPT-6 Astra : focus développeur et 3D
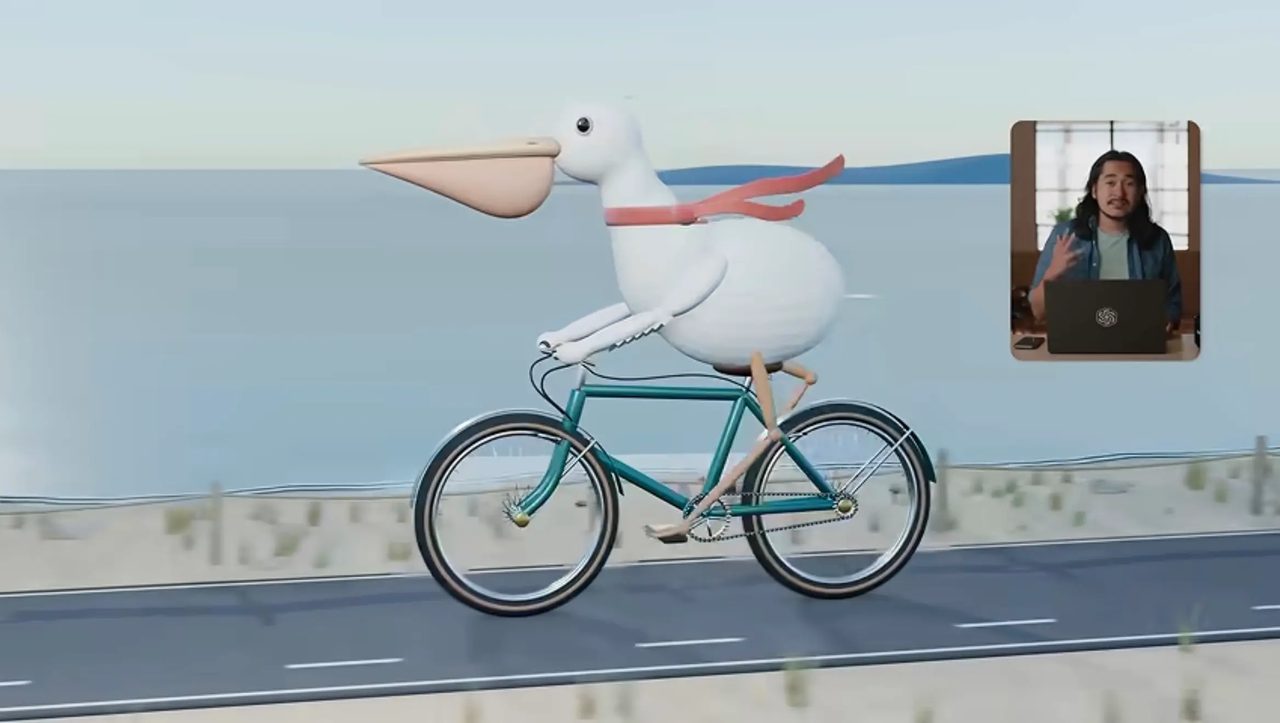 OpenAI présente GPT-6 Astra pour les développeurs. Le modèle démontre « plus d’attention au détail, une meilleure compréhension de la requête utilisateur, et peut construire des sorties plus sophistiquées » [11]. La capability 3D est mise en avant : Simon Willison rapporte avoir vu des créations « incroyables » [11]. Par ailleurs, Blender fonctionne avec les agents de codage sur macOS via l’application complète installée depuis blender.org [1].
Pourquoi ça compte : si vous construisez des outils de génération 3D ou des pipelines créatifs, GPT-6 Astra change la donne sur la qualité des sorties — testez-le avec Blender sur macOS, l’intégration est directe [1][11].
⚙️ Génération de kernels pour accélérateurs : MaxKernel
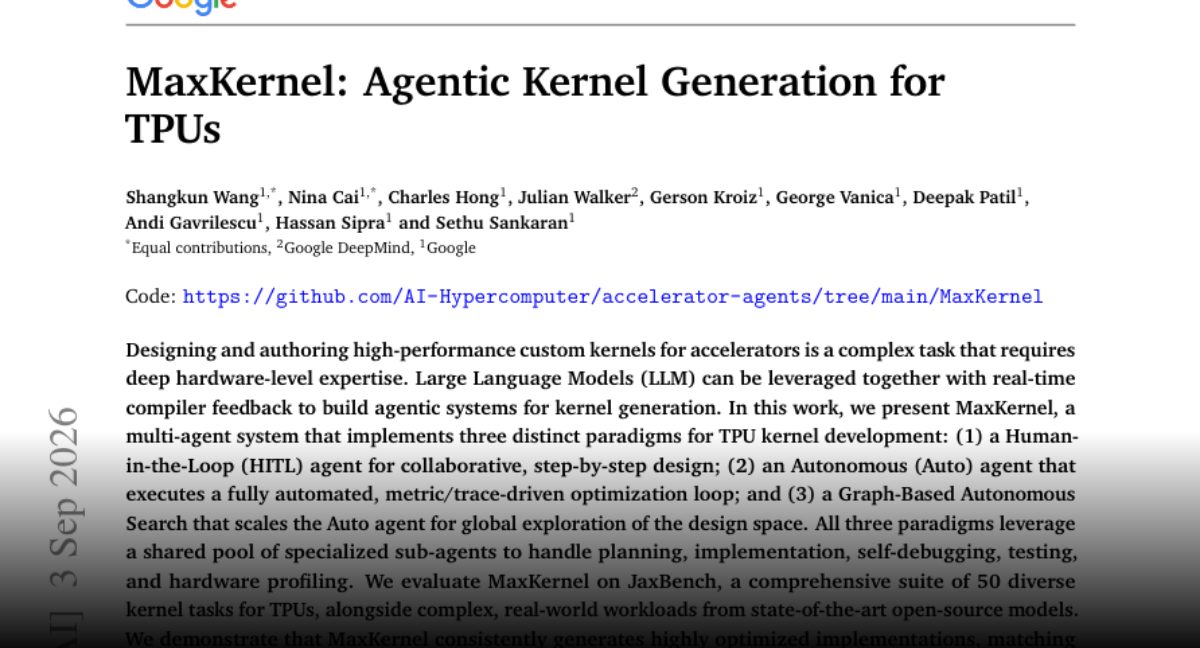 MaxKernel présente un système multi-agents qui conçoit et écrit des kernels haute performance pour accélérateurs, en s’appuyant sur des LLM couplés à un feedback compilateur en temps réel [3]. La conception manuelle de kernels exige une expertise matérielle profonde ; l’approche agentique automatise ce processus [3].
Pourquoi ça compte : si vous optimisez des workloads sur accélérateurs, cette approche peut réduire drastiquement le temps de développement de kernels custom — le feedback compilateur temps réel élimine les cycles d’essai-erreur manuels [3].
🔍 Agents de recherche à l’échelle : Iris
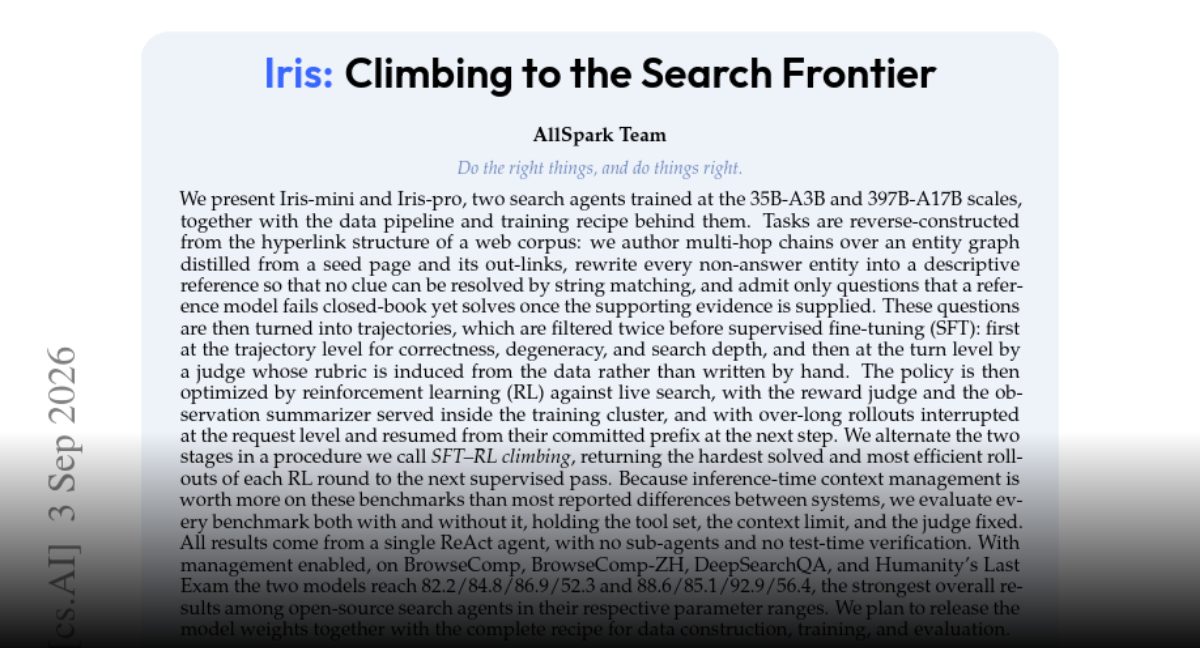 Iris-mini (35B-A3B) et Iris-pro (397B-A17B) sont deux agents de recherche entraînés avec un pipeline de données où les tâches sont « reverse-construites » depuis la structure hypertexte d’un corpus web : des chaînes multi-sauts sont générées sur un graphe d’entités [15].
Pourquoi ça compte : si vous construisez des agents de recherche ou des systèmes RAG, l’approche d’entraînement par reverse-construction depuis le web est reproductible et scalable — les poids 397B-A17B indiquent une capacité de raisonnement multi-sauts sérieuse [15].
À retenir
- 397B-A17B — taille d’Iris-pro, l’agent de recherche entraîné par reverse-construction de tâches depuis le web [15]
- 85 millions — nouvelles inscriptions de domaines liées à des arnaques, selon un rapport Interisle cité par Terence Eden [9]
- 604 points — score Hacker News pour l’essai de Bryan Cantrill sur l’usage des LLM pour rédiger des posts [2]
🛠 Tuto du jour
Tuto / Outil : Using Blender with coding agents on macOS [1] Ce qu’on installe : L’application macOS complète de Blender pour l’utiliser avec des agents de codage. Prérequis hardware & commande : Mac ; installer depuis blender.org, puis lancer un prompt type “Use the already installed /Applications/Blender to render a scene…” [1]
💻 Matos & Infra local
Sujet Matos/Infra : Quantization et mémoire récurrente — [13] Constat technique : La quantification modifie l’écriture de l’état récurrent, ce qui altère les calculs aux pas suivants en inférence temporelle basse précision [13]. Recommandation dev : Valider la règle de write-back de l’état quantifié avant de déployer des modèles récurrents en local [13]. Sujet Matos/Infra : Rendu 3D sur Mac — [1] Constat technique : Blender fonctionne avec des agents de codage sur macOS via l’application complète installée depuis blender.org [1]. Recommandation dev : Utiliser l’installation native Mac pour piloter le rendu 3D par agents [1]. Sujet Matos/Infra : Agents open-source sur site — [6] Constat technique : Les modèles open-source sous-performent pour l’appel multi-étapes d’APIs gouvernementales en déploiement sur site [6]. Recommandation dev : Mesurer l’écart avant de choisir un modèle local pour ce type de chaînage [6].
🎯 Fine-Tuning & Quantiz
Technique / Outil : Recurrent-state write-back en inférence temporelle low-precision [13] Apport : La règle de stockage de l’état quantifié modifie les calculs ultérieurs ; l’article introduit une méthode dédiée pour ce contexte [13]. Impact pratique : À intégrer lors de la quantification de réseaux récurrents pour préserver la dynamique temporelle [13].
🧠 RAG & Agents Locaux
Architecture / Outil : Multi-Step Tool-Calling over Korean Open Public APIs [6] Cas d’usage : Déploiement on-premise d’agents LLM open-source chaînant plusieurs appels d’outils sur des API gouvernementales coréennes, contraint par les régulations de souveraineté des données [6]. Clé de voûte : Benchmark dédié et recette de synthèse de données pour mesurer et améliorer la performance des modèles open-source en environnement local [6].
📊 Track Record
Ce qu’on disait le 2026-08-24 : Anthropic passe de 47 à 65 Md$ de revenus annualisés entre mai et juillet, mais son meilleur modèle peine à attirer les utilisateurs [8] Verdict aujourd’hui : En attente. Aucun élément du jour ne permet de confirmer ou d’infirmer la difficulté d’adoption du modèle. La trajectoire de revenus n’est pas non plus actualisée dans les sources actuelles. Le signal reste sans preuve nouvelle [1]-[18]. Pas assez de recul pour un track record cette semaine.
🔗 Sources (18) — vérifiées le 07/09/2026 05:00 UTC
- Using Blender with coding agents on macOS — Simon Willison · 2026-09-05
- Your intellectual fly is open when you use an LLM to author a post (2025) — Hacker News · 2026-09-06
- MaxKernel: Agentic Kernel Generation for TPUs — HF Papers
- QCell: Recombining and Aligning Cell Queries for Overlapping Instance Segmentation — HF Papers
- Same Trajectory, Contradictory Rewards (ROBORMBENCH): Paraphrase Fragility in Vision Language Reward Models — arXiv · 2026-09-04
- Multi-Step Tool-Calling over Korean Open Public APIs: A Benchmark and a Data-Synthesis Recipe — arXiv · 2026-09-04
- CUA-Universe: A Scalable and Dynamic Environment for Hybrid GUI+CLI Agents — arXiv · 2026-09-04
- Distill Globally, Adapt Locally: Reasoning Distillation and Product-Type Test-Time Training for Scalable Trade-Up Recommendation — arXiv · 2026-09-04
- The purpose of DNS is to spread scams — Simon Willison · 2026-09-06
- Quoting Zach Kehs — Simon Willison · 2026-09-06
- Introducing GPT-6 Astra for developers — Simon Willison · 2026-09-05
- AdaptVPR: Route-Aware Hard Positive Generation for Robust Visual Place Recognition — HF Papers
- When Quantization Breaks Memory: Recurrent-State Write-Back in Low-Precision Temporal Inference — HF Papers
- Don’t Drop Dropout: Optimizing Layer Sparsity for Efficient LLM Training and Inference — HF Papers
- Iris: Climbing to the Search Frontier — HF Papers
- DRACO: Fine-Grained Credit Assignment with Dynamic Rubrics for Long-Horizon Agent Training — HF Papers
- Using Grounded Theory for Agent Behavior Analysis at Scale — HF Papers
- LLMs as a Cognitive Virus — Hacker News · 2026-09-05
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.