Partager ce rapport :
TL;DR
- GLM-5.3-Flash et Qwen3.8-Flash-Next dominent Hacker News avec 939 et 652 points [1][2]
- Un modèle 4-bit compressé surpasse son original full-precision via Quantization-Aware Healing [3]
- EVE Online entame sa migration vers Python 3 après 16 ans sous Stackless Python 2.7 [12]
Les 3 signaux
🚀 Modèles Flash : la course à l’inférence légère s’intensifie
 GLM-5.3-Flash et Qwen3.8-Flash-Next concentrent l’attention avec respectivement 939 points et 652 points [1][2]. Le positionnement « Flash » des deux modèles indique une focalisation sur la latence et le coût d’inférence. La publication simultanée suggère une concurrence directe sur ce segment.
Pourquoi ça compte : deux alternatives open-source viables pour de l’inférence à grande échelle à coût réduit — à évaluer pour remplacer des modèles plus lourds en production.
🧠 La compression 4-bit dépasse le full-precision
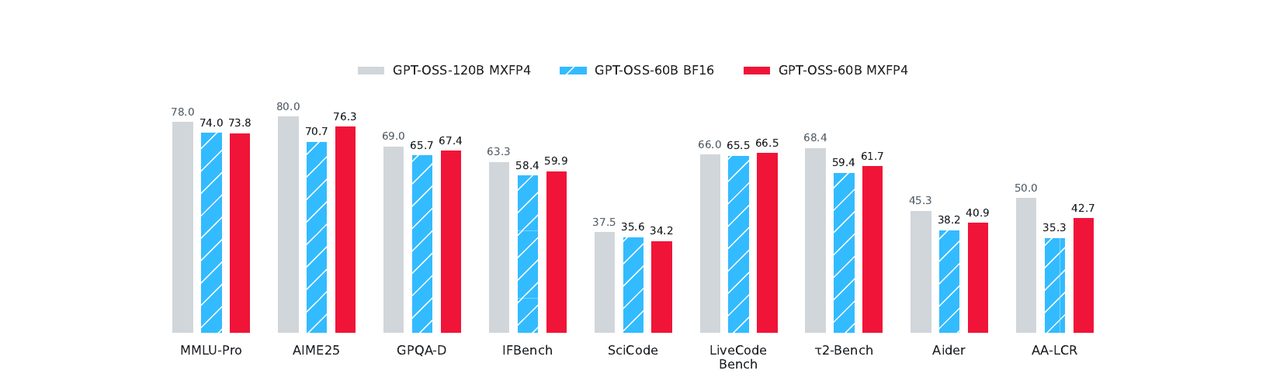 Le blog Hugging Face de MultiverseComputingCAI présente une approche nommée Quantization-Aware Healing : un modèle compressé en 4-bit surpasse son original en full-precision [3]. Le terme « healing » suggère un processus de récupération de performance post-quantization, probablement par fine-tuning ciblé ou ajustement adaptatif.
Pourquoi ça compte : si la technique se généralise, elle réduit drastiquement les coûts mémoire et inférence sans sacrifier la qualité — un levier direct sur les coûts GPU.
🐍 EVE Online migre enfin vers Python 3
 EVE Online, sur Stackless Python 2.7 depuis 2010, lance sa migration vers Python 3 [12]. Le jeu tourne sur Stackless Python depuis 2003 et constitue un cas d’étude de Python à l’échelle depuis plus de vingt ans. La migration d’un système de cette ancienneté et de cette taille est un chantier majeur.
Pourquoi ça compte : un cas de référence pour toute migration Python 2→3 sur un codebase legacy massif — les patterns et pièges documentés par CCP seront réutilisables.
À retenir
- 939 points — GLM-5.3-Flash, le score HN le plus élevé du jour [1]
- 4-bit — compression qui surpasse le full-precision via Quantization-Aware Healing [3]
- 16 ans — durée de vie de Stackless Python 2.7 chez EVE Online avant migration [12]
🛠 Tuto du jour
Tuto / Outil : Quantization-Aware Healing [3] Ce qu’on installe : Un modèle compressé en 4-bit qui surpasse son original en précision complète. Prérequis hardware & commande : Non spécifié dans les éléments fournis.
💻 Matos & Infra local
Sujet Matos/Infra : Quantization-Aware Healing, modèle 4-bit surpassant l’original full-precision [3] Constat technique : Un modèle compressé en 4-bit surpasse son équivalent en pleine précision, remettant en cause le compromis habituel entre taille de VRAM et qualité d’inférence. Recommandation dev : Évaluer cette approche pour réduire l’empreinte mémoire locale sans sacrifier les performances.
🎯 Fine-Tuning & Quantiz
Technique / Outil : Quantization-Aware Healing, modèle 4-bit [3] Apport : Le modèle compressé surpasse l’original en précision plein format [3] Impact pratique : Réduit la mémoire tout en améliorant les performances, sans perte de qualité [3]
Technique / Outil : Group-Shared Low-Rank Approximation [8] Apport : Réduit la croissance quadratique des paramètres des CNN à large noyau [8] Impact pratique : Facilite le déploiement sur appareils mobiles à mémoire limitée [8]
🧠 RAG & Agents Locaux
Architecture / Outil : TraceML [7]
Cas d’usage : Évaluation de la planification humain-agent dans le développement ML autonome, où l’agent révise pipelines et modèles sur des heures de feedback.
Clé de voûte : Analyse empirique des traces d’interaction, pas de vector DB ; stratégie centrée sur la révision itérative et la validation.
Architecture / Outil : JIT-Agent [15]
Cas d’usage : Génération automatique de harnais d’agent (mémoire, planification, orchestration d’outils) pour tâches spécifiques.
Clé de voûte : Évolution du harnais en temps réel, sans base vectorielle ; optimisation du protocole d’action.
📊 Track Record
Ce qu’on disait le 2026-08-09 : Qwen3.8 Max passe n°1 de l’agentic index, classement global des modèles [2] Verdict aujourd’hui : partiellement tenu. La famille s’étend avec Qwen3.8-Flash-Next, très discuté sur Hacker News (652 points) [2], mais aucun élément ne confirme le maintien de la position n°1 de Max. Le classement global n’est pas réévalué dans les sources du jour. En attente de confirmation.
🔗 Sources (18) — vérifiées le 27/08/2026 05:00 UTC
- GLM-5.3-Flash — Hacker News · 2026-08-26
- Qwen3.8-Flash-Next — Hacker News · 2026-08-26
- Quantization-Aware Healing: a compressed, 4-bit model that outperforms its full-precision original — Hugging Face · 2026-08-25
- WarpSAC: Towards the Pinnacle of Scalable Off-policy RL by Rethinking Exploration and Exploitation — HF Papers
- FrontierChallenge: Evaluating Scientific Workflow Completion — HF Papers
- Agentic Autoresearch for Cell-Edge Power Control: Radically Redefining the Researcher’s Role — arXiv · 2026-08-26
- TraceML: An Empirical Analysis of Human-Agent Planning in Machine Learning Development — arXiv · 2026-08-26
- Group-Shared Low-Rank Approximation for Mobile-Efficient Pointwise Convolutions in Large-Kernel CNNs — arXiv · 2026-08-26
- $R^3$: Training Robots to Reason in Natural Language via Reinforcement Learning — arXiv · 2026-08-26
- Trace Integrity for LLM Data Agents: A Vision for Auditable Structured Reasoning in Real-World Systems — arXiv · 2026-08-26
- Quoting Paul Dix — Simon Willison · 2026-08-26
- EVE Online: The Move to Python 3 Begins! — Simon Willison · 2026-08-25
- Stream4D: 4D-Consistency for Streaming Autoregressive Diffusion Video Models — HF Papers
- V-Rubrics: Visual Faithfulness via Rubric-Based Reinforcement Learning — HF Papers
- JIT-Agent: Scaling Harness Intelligence via Just-in-Time Harness Evolution — HF Papers
- Super Star: Towards Streaming Real-time Interactive Agents for Digital Humans — HF Papers
- A Programming Paradigm for Spatiotemporal Composability — HF Papers
- Agent-G^2: Gaussian Guidance for Agentic Reinforcement Learning — HF Papers
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.