Partager ce rapport :
Résumé hebdo — Semaine 34
6 rapports de veille · 17 - 22 août 2026 · Modèles, Open-Source, Infrastructure, Agents
💡 Les convergences & implications tech de la semaine
- [22 août] les chaînes d’outils CLI retrouvent une stabilité immédiate, et l’accès aux traces de raisonnement via OpenRouter devient utilisable sans bidouille. En savoir plus →
- [22 août] un gain de cette ampleur sur l’inférence change les calculs de coût et de latence pour tout déploiement en production. En savoir plus →
- [22 août] le cache sur SSD réduit drastiquement la latence de reprise de session sur Apple Silicon, et Bun.WebView ouvre une voie légère pour des UIs natives sans Electron. En savoir plus →
- [21 août] 3,2× de débit en plus sur le même hardware, soit une baisse directe de la facture d’inférence ou une montée en charge sans ajout de GPU. En savoir plus →
- [21 août] Bun.WebView ouvre une voie pour exposer des APIs JSON depuis une WebView embarquée, sans serveur séparé — un pattern utile pour des outils locaux légers. En savoir plus →
- [21 août] les sessions longues sur Apple Silicon reprennent instantanément sans repasser par le calcul du contexte, au prix d’un usage disque borné à 10 %. En savoir plus →
- [20 août] alternative open-source viable pour écrire des kernels performants sans quitter l’écosystème Python, avec une licence permissive pour l’intégrer en production. En savoir plus →
- [20 août] le coût d’entrée pour faire tourner des modèles à contexte long ou des quantifications lourdes chute drastiquement, sans passer par du matériel neuf à plusieurs milliers d’euros. En savoir plus →
- [20 août] si les LLMs passent ce benchmark, ils peuvent générer des kernels optimisés plus vite que les bibliothèques standard, avec un gain de performance direct sur les workloads d’inférence et d’entraînement. En savoir plus →
- [19 août] alternative open-source viable pour écrire des kernels et pipelines haute performance sans dépendre d’un vendor fermé. En savoir plus →
- [19 août] un modèle de 27B paramètres rivalise avec des modèles 30 à 60 fois plus gros, ce qui change les calculs de coûts d’inférence et ouvre des déploiements sur du matériel modeste. En savoir plus →
- [19 août] 22 Go de VRAM à ce prix rend l’inférence de modèles 13B-27B quantifiés accessible sur du matériel d’occasion, sans passer par du cloud. En savoir plus →
- [18 août] un modèle de 27B tournant sur un laptop raisonnable rivalise avec des modèles de plusieurs centaines de milliards de paramètres, ce qui change le calcul coût/latence pour l’inférence locale. En savoir plus →
- [18 août] si des données physiques non numérisées sont massivement collectées pour l’entraînement, les modèles futurs intègrent des contenus hors du périmètre des accords de licence classiques — un risque juridique et éthique à anticiper côté conformité. En savoir plus →
- [18 août] si tu conçois des agents avec un budget d’inférence global (coût, tokens), ce benchmark révèle que les modèles ne savent pas prioriser entre tâches — un facteur à intégrer dans la conception de ton orchestrateur. En savoir plus →
- [17 août] alternative open-source viable pour de l’inférence locale, mais vous devrez probablement ajuster les paramètres de raisonnement pour éviter une latence inutile en production. En savoir plus →
- [17 août] si cette architecture tient ses promesses, elle permet de traiter des séquences longues avec un coût mémoire borné, sans sacrifier la parallélisation à l’entraînement. En savoir plus →
- [17 août] si vous développez avec des modèles locaux ou via des proxies, cet outil simplifie le test d’interopérabilité des endpoints sans écrire de client custom. En savoir plus →
📅 22 août 2026 : llm-openrouter 0.7 compatible LLM 0.32, affiche les traces de raisonnement, ajoute 3 outils serveur
llm-openrouter 0.7 compatible LLM 0.32, affiche les traces de raisonnement, ajoute 3 outils serveur · LFM2.5-DSpark annonce jusqu’à 3,2× d’inférence plu…
TL;DR
- llm-openrouter 0.7 compatible LLM 0.32, affiche les traces de raisonnement, ajoute 3 outils serveur [3]
- LFM2.5-DSpark annonce jusqu’à 3,2× d’inférence plus rapide [4]
- Bun 1.4 sort, première version stable post-réécriture Rust, avec Bun.WebView [16]
Lire le rapport complet →
📅 21 août 2026 : LFM2.5-DSpark accélère l’inférence jusqu’à 3,2×
LFM2.5-DSpark accélère l’inférence jusqu’à 3,2× · Bun 1.4 sort en stable, première version depuis le rewrite Rust · oMLX écrit le cache KV sur SSD, acti…
TL;DR
- LFM2.5-DSpark accélère l’inférence jusqu’à 3,2× [2]
- Bun 1.4 sort en stable, première version depuis le rewrite Rust [11]
- oMLX écrit le cache KV sur SSD, active le cache d’office [3]
Les 3 signaux
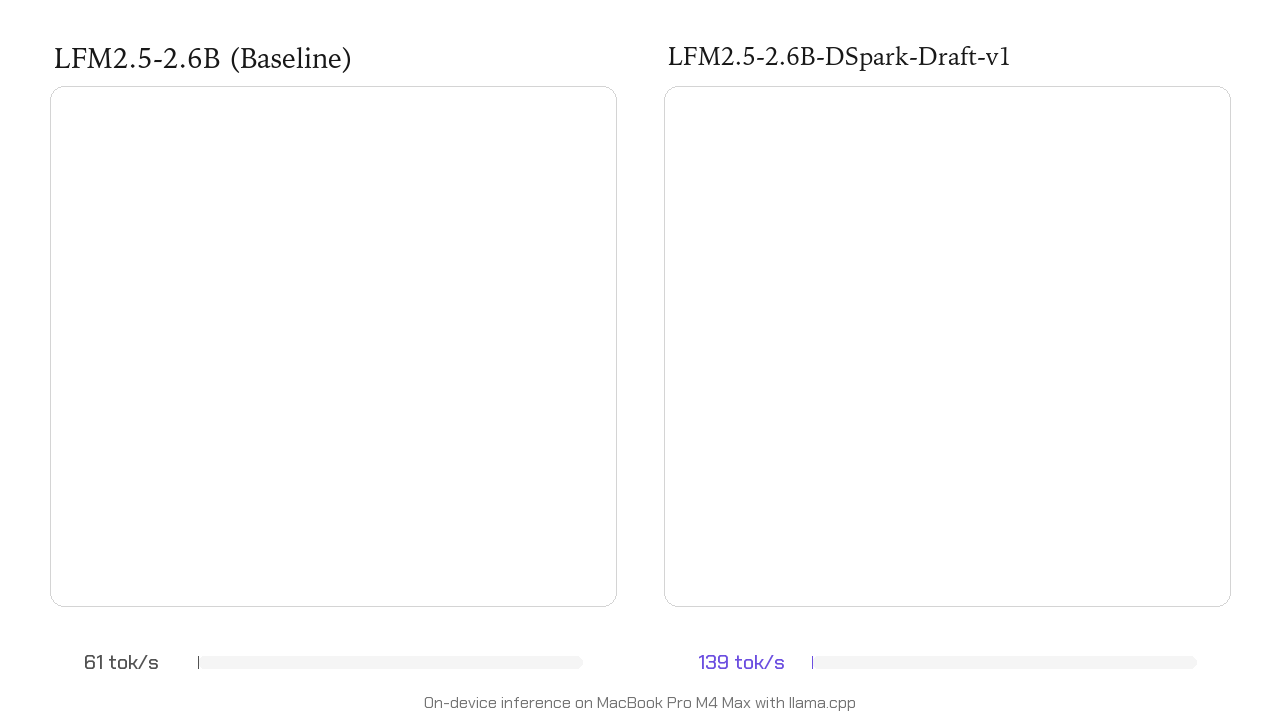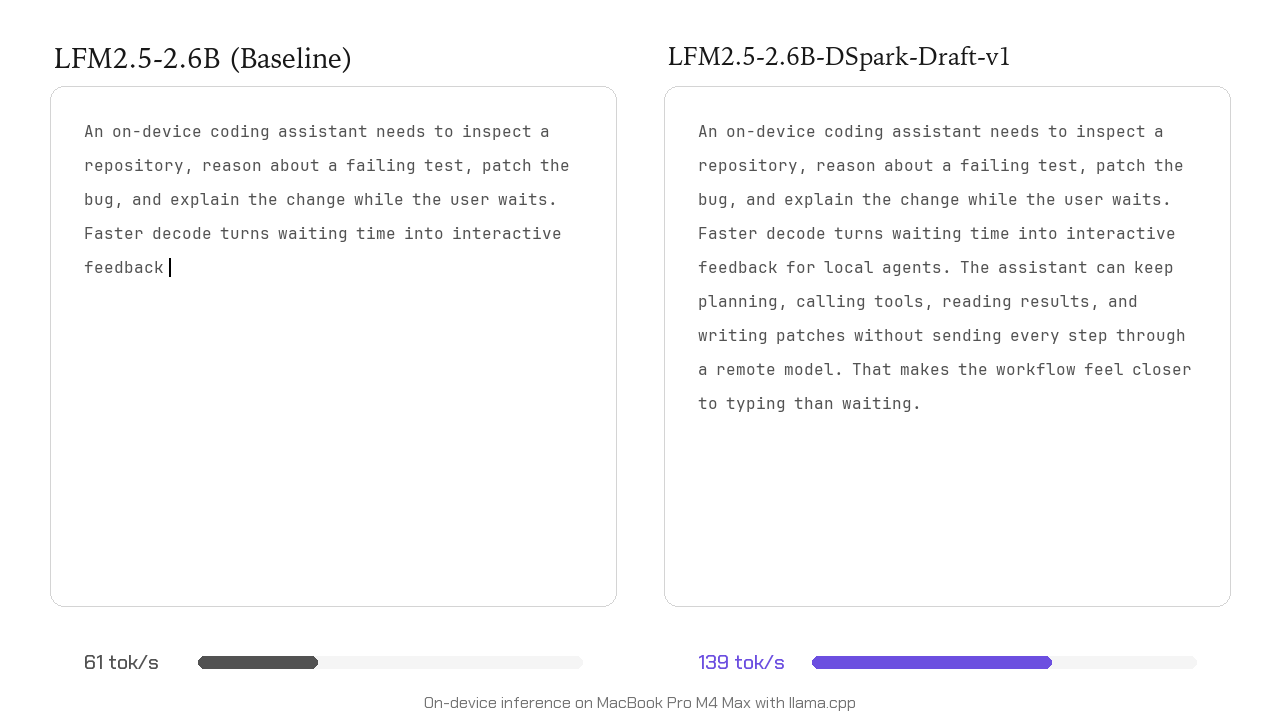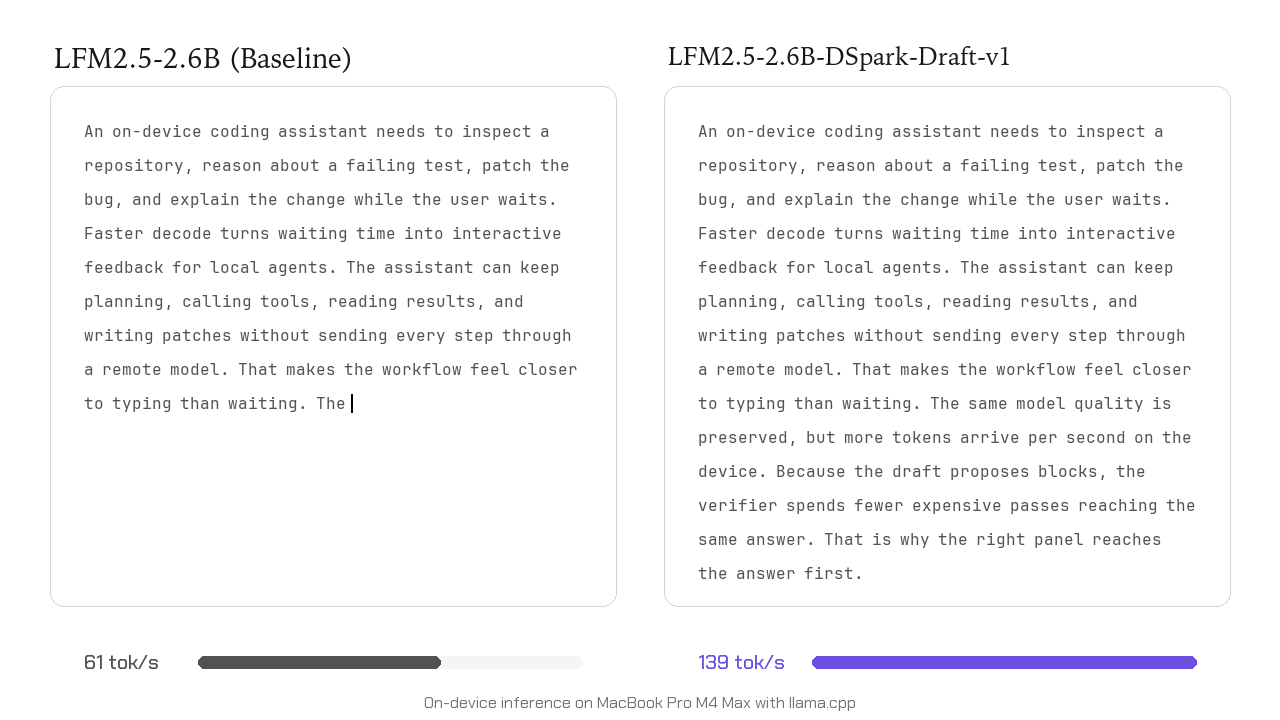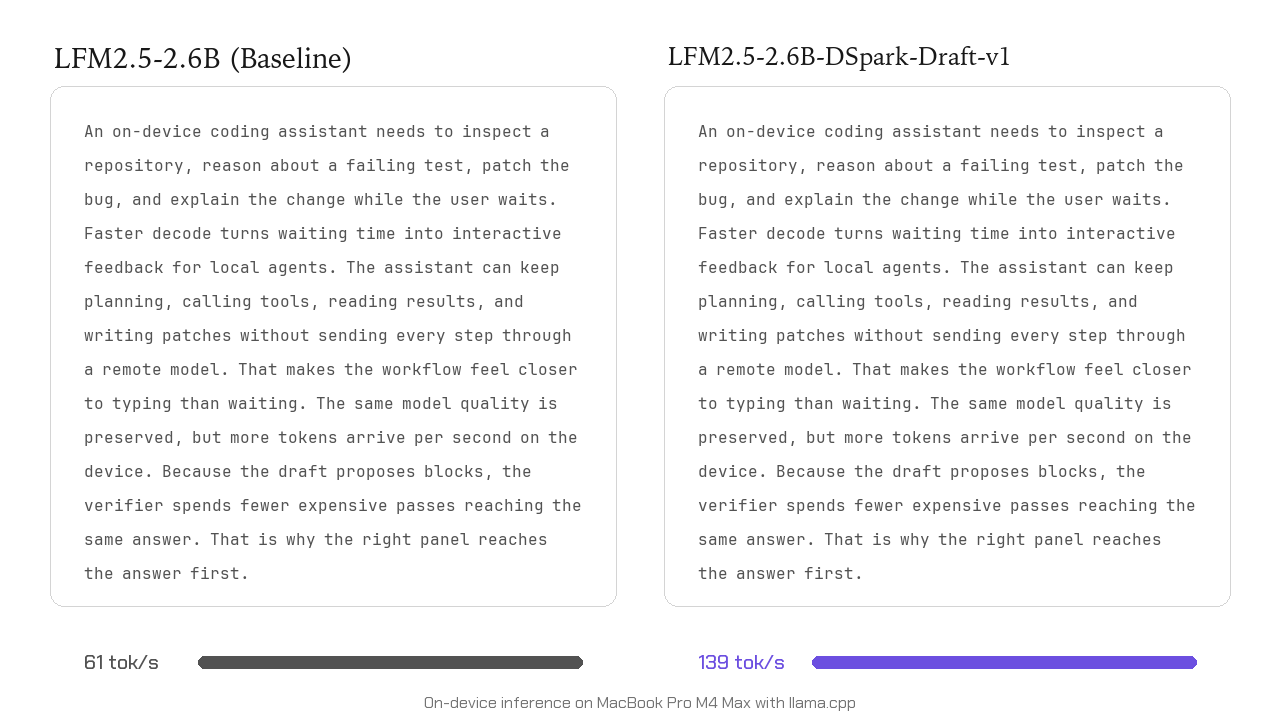
⚡ Inférence — Liquid AI publie LFM2.5-DSpark avec des gains d’inférence jusqu’à 3,2× [2]. Les détails techniques restent sur Hugging Face, mais l’ordre de grandeur est net pour qui cherche à réduire la latence ou les coûts de serving.
**Pourquoi ça…
Lire le rapport complet →
📅 20 août 2026 : Mojo🔥 passe en open source sous licence Apache 2, compilateur et toolchain inclus
Mojo🔥 passe en open source sous licence Apache 2, compilateur et toolchain inclus · Un atelier japonais double la VRAM des RTX 2080 Ti à 22 Go pour 282 …
TL;DR
- Mojo🔥 passe en open source sous licence Apache 2, compilateur et toolchain inclus [3]
- Un atelier japonais double la VRAM des RTX 2080 Ti à 22 Go pour 282 dollars [5]
- PTXBench sort : benchmark pour adapter les LLMs à l’optimisation de kernels GPU via PTX [9]
Lire le rapport complet →
📅 19 août 2026 : Mojo 1.0 passe en open source, compilateur et toolchain sous licence Apache 2
Mojo 1.0 passe en open source, compilateur et toolchain sous licence Apache 2 · Qwen 3.8 27B atteint 52 au Artificial Analysis Intelligence Index, score…
TL;DR
- Mojo 1.0 passe en open source, compilateur et toolchain sous licence Apache 2 [2]
- Qwen 3.8 27B atteint 52 au Artificial Analysis Intelligence Index, score égal à GPT-5.6 Luna (max) [12]
- Un atelier japonais double la VRAM des RTX 2080 Ti à 22 Go pour 282 dollars [4]
Lire le rapport complet →
📅 18 août 2026 : Qwen 3.8 27B atteint 52 à l’Artificial Analysis Intelligence Index, score égal à GPT-5.6 Luna (max)
Qwen 3.8 27B atteint 52 à l’Artificial Analysis Intelligence Index, score égal à GPT-5.6 Luna (max) · Des commandes massives de livres rares par des cli…
TL;DR
- Qwen 3.8 27B atteint 52 à l’Artificial Analysis Intelligence Index, score égal à GPT-5.6 Luna (max) [4]
- Des commandes massives de livres rares par des clients anonymes insensibles au prix aboutissent dans un centre d’entraînement IA d’Amazon [1]
- R^3-Bench montre que les LLM échouent au raisonn…
Lire le rapport complet →
📅 17 août 2026 : Qwen 3.8 27B sort sous licence Apache 2, mais sur-réfléchit par défaut
Qwen 3.8 27B sort sous licence Apache 2, mais sur-réfléchit par défaut · Simon Willison publie CORS Chat, UI web pour tester des endpoints compatibles O…
TL;DR
- Qwen 3.8 27B sort sous licence Apache 2, mais sur-réfléchit par défaut [6]
- Simon Willison publie CORS Chat, UI web pour tester des endpoints compatibles OpenAI-Responses [1]
- Maglev introduit une architecture Transformer récurrente à mémoire fixe, parallélisable en entraînement [2]