Partager ce rapport :
TL;DR
- Mojo🔥 passe en open source sous licence Apache 2, compilateur et toolchain inclus [3]
- Un atelier japonais double la VRAM des RTX 2080 Ti à 22 Go pour 282 dollars [5]
- PTXBench sort : benchmark pour adapter les LLMs à l’optimisation de kernels GPU via PTX [9]
Les 3 signaux
🦾 Mojo🔥 tient sa promesse open source
 Le langage Mojo, qui promettait une release open source depuis mai 2023, livre enfin. Après la sortie de la version 1.0 la semaine dernière, le compilateur et la toolchain sont désormais publiés sous licence Apache 2 [3]. L’objectif initial annoncé au lancement est ainsi tenu [3].
Pourquoi ça compte : alternative open-source viable pour écrire des kernels performants sans quitter l’écosystème Python, avec une licence permissive pour l’intégrer en production.
💾 22 Go de VRAM sur RTX 2080 Ti pour 282 dollars
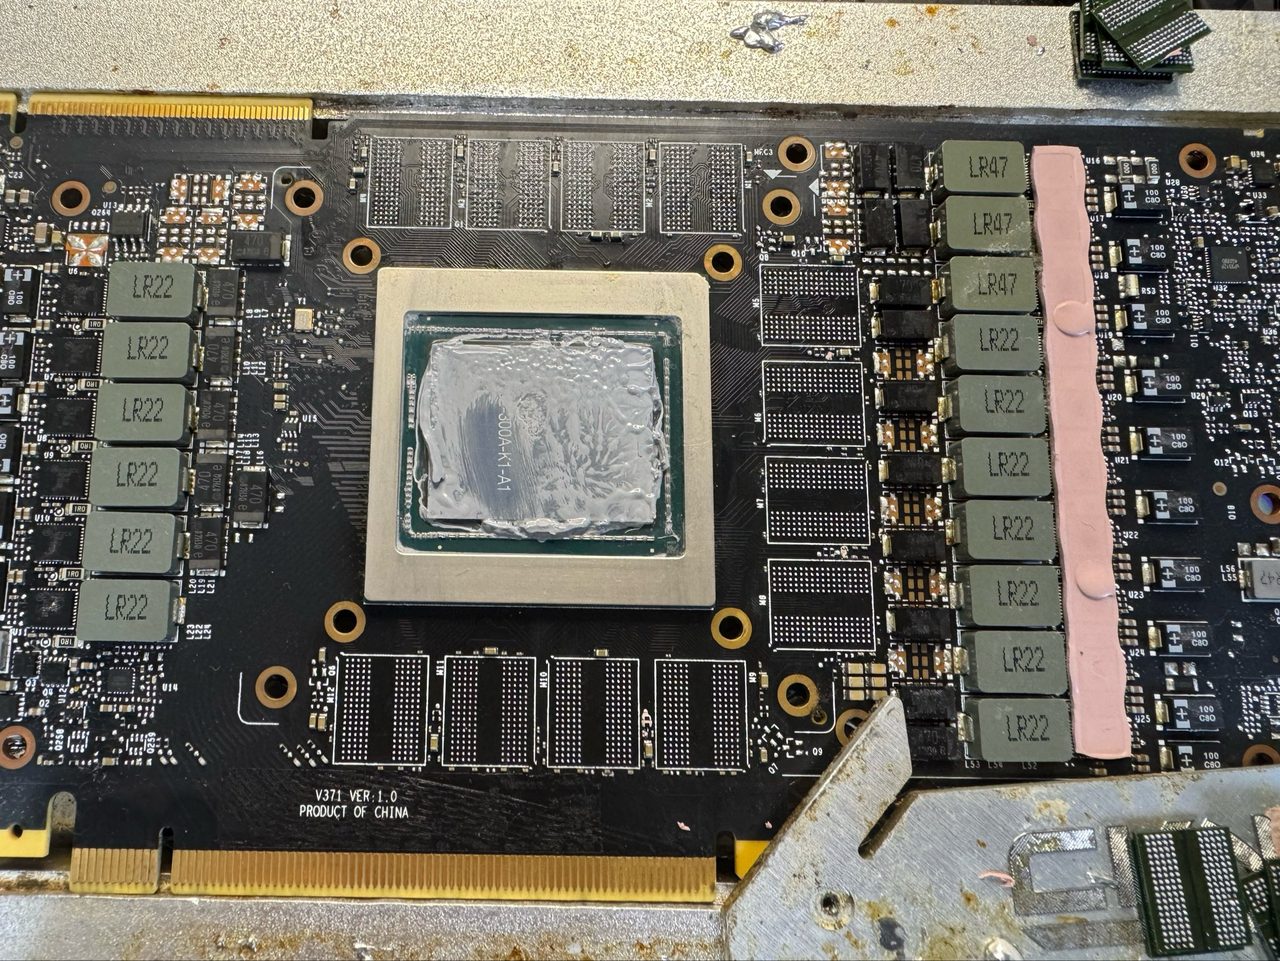 Un atelier de Saitama remplace les 11 puces GDDR6 des RTX 2080 Ti par des modules Samsung 2 Go. Résultat : 22 Go de VRAM au lieu de 11, pour 282 dollars [5]. L’opération vise explicitement l’IA locale [5].
Pourquoi ça compte : le coût d’entrée pour faire tourner des modèles à contexte long ou des quantifications lourdes chute drastiquement, sans passer par du matériel neuf à plusieurs milliers d’euros.
⚡ PTXBench : benchmark pour LLMs spécialisés en optimisation GPU
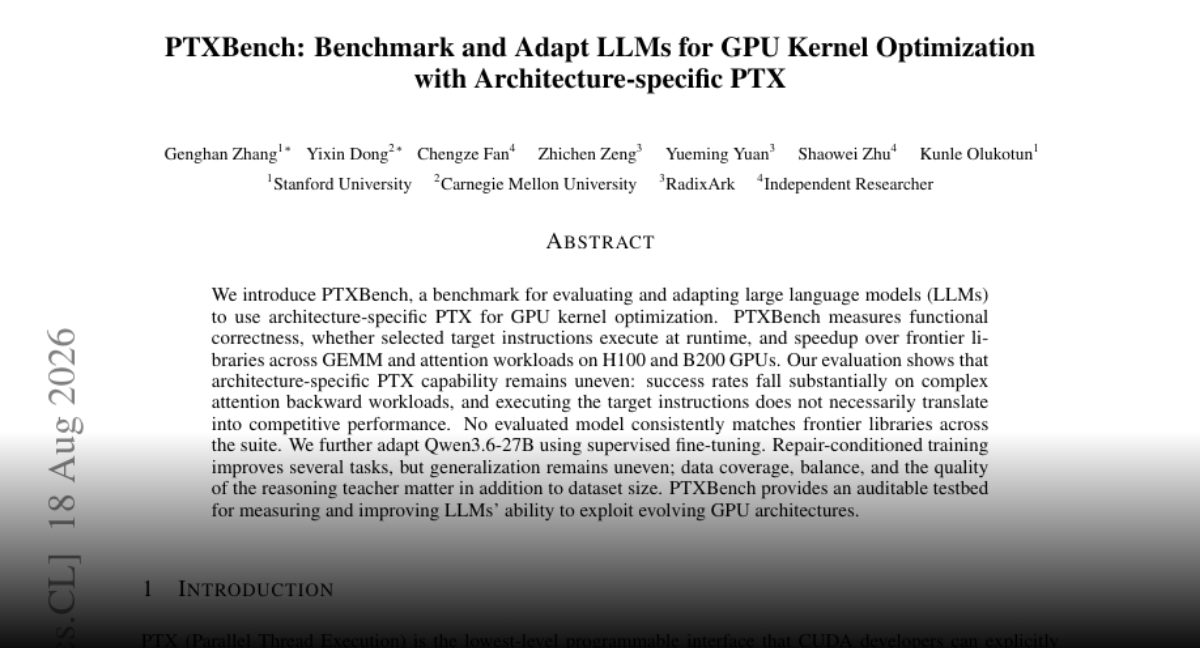 PTXBench évalue et adapte les LLMs à l’utilisation de PTX spécifique à une architecture pour l’optimisation de kernels GPU. Le benchmark mesure la correction fonctionnelle, l’exécution réelle des instructions ciblées au runtime, et le speedup par rapport aux bibliothèques de référence sur des workloads GEMM et attention [9].
Pourquoi ça compte : si les LLMs passent ce benchmark, ils peuvent générer des kernels optimisés plus vite que les bibliothèques standard, avec un gain de performance direct sur les workloads d’inférence et d’entraînement.
À retenir
- Apache 2 — licence sous laquelle Mojo publie compilateur et toolchain, après la 1.0 sortie la semaine dernière [3]
- 22 Go — VRAM obtenue sur RTX 2080 Ti après remplacement des puces GDDR6 par des modules Samsung 2 Go, pour 282 dollars [5]
- 39 jours — temps qu’il a fallu pour cracker le CD shareware de Quake en 1996, alors que la faille était décrite dans un brevet de 1992 [2]
🛠 Tuto du jour
Tuto / Outil : Aucun tuto d’installation locale identifié aujourd’hui.
💻 Matos & Infra local
Sujet Matos/Infra : Doublement de VRAM sur RTX 2080 Ti pour l’IA locale [5] Constat technique : Un atelier remplace les puces GDDR6 par des modules Samsung 2 Go pour 282 dollars, portant la carte à 22 Go de VRAM. Recommandation dev : Envisagez cette option pour étendre la capacité d’inférence locale à moindre coût. Sujet Matos/Infra : Checkpoints LFM2.5 Q4_0 issus de distillation consciente de la quantification [1] Constat technique : Publication de checkpoints quantifiés en Q4_0, conçus pour l’inférence locale. Recommandation dev : Évaluez ces checkpoints pour réduire l’empreinte mémoire sans réglage post-quantification.
🎯 Fine-Tuning & Quantiz
Technique / Outil : LFM2.5 Q4_0 Checkpoints from Quantization-Aware Distillation [1] Apport : Quantification Q4_0 issue d’une distillation tenant compte de la quantification, publiée par LiquidAI. Impact pratique : Offre des checkpoints directement exploitables pour une inférence locale allégée en mémoire. Technique / Outil : PTXBench [9] Apport : Benchmark et adaptation de LLMs pour l’optimisation de kernels GPU via PTX spécifique à l’architecture. Impact pratique : Mesure la correction fonctionnelle et le speedup sur GEMM et attention pour guider le fine-tuning.
🧠 RAG & Agents Locaux
Architecture / Outil : fx, agent de codage natif open source [13] Cas d’usage : Exécution d’un agent autonome de génération de code entièrement en local, sans dépendance à un service cloud. Clé de voûte : Agent natif minimaliste, conçu pour fonctionner de bout en bout sur la machine de l’utilisateur [13].
📊 Track Record
Ce qu’on disait le 2026-08-06 : Liquid AI déploie LFM2.5-2.6B pour agents locaux [3] Verdict aujourd’hui : partiellement tenu. Le 19/08, Liquid AI publie un blog détaillant les checkpoints Q4_0 de LFM2.5 via distillation sensible à la quantification (QAD) [1], confirmant la poursuite du déploiement local. Toutefois, aucune preuve d’adoption massive ou de benchmark comparatif n’est fournie [1].
🔗 Sources (18) — vérifiées le 20/08/2026 05:00 UTC
- LFM2.5 Q4_0 Checkpoints from Quantization-Aware Distillation — Hugging Face · 2026-08-19
- Le CD de Quake était foireux avant même d’être pressé — Korben · 2026-08-19
- Mojo🔥 is now open source — Simon Willison · 2026-08-18
- How Much Memory Does Your Agent Actually Need? — Hugging Face · 2026-08-18
- Un atelier japonais double la VRAM des RTX 2080 Ti pour pas cher — Korben · 2026-08-18
- Co-RL: Unsupervised Reasoning Emerges from Diverse Cohort in Multi-agent RL — HF Papers
- Looped Language Models Improve Compositional Tool Calling — HF Papers
- FM-Bench: A Benchmark for Long-Horizon Management with Competing Agents — HF Papers
- PTXBench: Benchmark and Adapt LLMs for GPU Kernel Optimization with Architecture-specific PTX — HF Papers
- PartialBiGrasp: Inferring Hidden Local Geometry for Bimanual Grasping from Partial Views — arXiv · 2026-08-19
- Beyond Teacher Likelihood: Group-Calibrated On-Policy Distillation for Long-Context Reasoning — arXiv · 2026-08-19
- Grouping the Stochastic Machine: Precision, Not Capability, as the Frontier Metric for AI Systems — arXiv · 2026-08-19
- fx :Tiny, open, native coding agent. — Hacker News · 2026-08-18
- smolmachines / smolvm as a sandbox for untrusted Python & JavaScript — Simon Willison · 2026-08-19
- Quoting Jeremy Morrell — Simon Willison · 2026-08-19
- OmniScientist: An Omni-Modal Omni-Discipline AI Scientist — HF Papers
- Zetta ζ: An Efficient Closed-Loop Embodied Harness for Self-Evolving Physical Intelligence — HF Papers
- Training Leaves Traces: Centered Residual Signatures for Language Model Lineage Verification — HF Papers
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.