Partager ce rapport :
TL;DR
- Mojo 1.0 passe en open source, compilateur et toolchain sous licence Apache 2 [2]
- Qwen 3.8 27B atteint 52 au Artificial Analysis Intelligence Index, score égal à GPT-5.6 Luna (max) [12]
- Un atelier japonais double la VRAM des RTX 2080 Ti à 22 Go pour 282 dollars [4]
Les 3 signaux
🦾 Mojo open source : la promesse de 2023 tenue
 Mojo sort son compilateur et sa toolchain sous licence Apache 2, trois ans après la promesse initiale de mai 2023 [2]. La sortie de la version 1.0 la semaine dernière précède cette ouverture [2]. Le langage, conçu pour la performance sur les workloads IA, est maintenant utilisable sans restriction de licence.
Pourquoi ça compte : alternative open-source viable pour écrire des kernels et pipelines haute performance sans dépendre d’un vendor fermé.
📊 Qwen 3.8 27B : score de 52, à égalité avec GPT-5.6 Luna
 Qwen 3.8 27B score 52 sur l’Artificial Analysis Intelligence Index [12]. Ce score égale GPT-5.6 Luna (max) et se place un point derrière GLM-5.2 (max) et DeepSeek V4 Pro 0813 (max) [12]. GLM fait 753B paramètres, DeepSeek 1.7T, Luna est de taille inconnue mais probablement bien supérieure à 27B [12].
Pourquoi ça compte : un modèle de 27B paramètres rivalise avec des modèles 30 à 60 fois plus gros, ce qui change les calculs de coûts d’inférence et ouvre des déploiements sur du matériel modeste.
🖥️ RTX 2080 Ti modifiée : 22 Go de VRAM pour 282 dollars
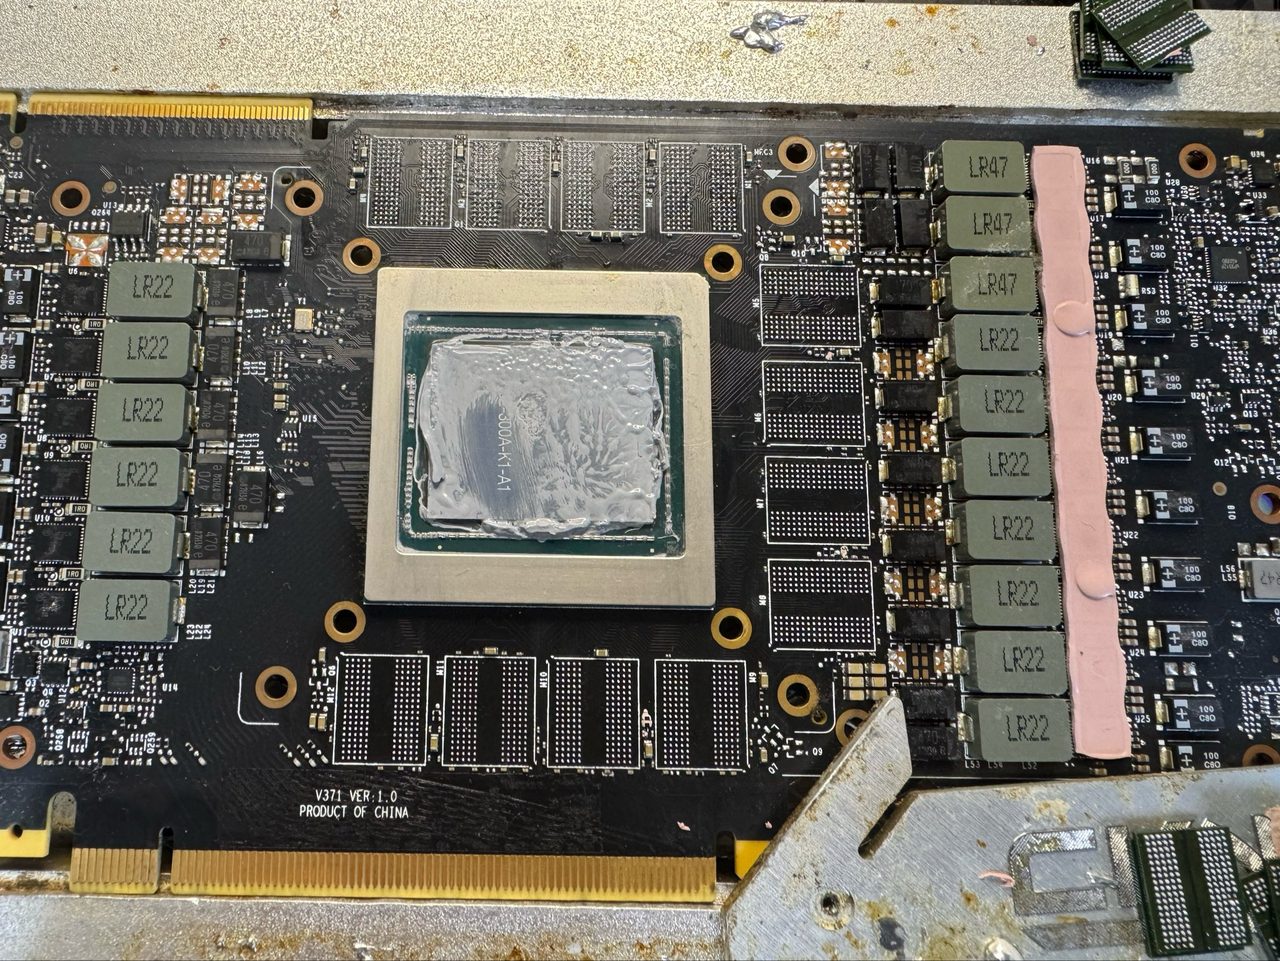 Un atelier de Saitama remplace les 11 puces GDDR6 des RTX 2080 Ti par des modules Samsung 2 Go [4]. Résultat : 22 Go de VRAM, utile pour l’IA locale [4]. Le prix de 282 dollars couvre la modification.
Pourquoi ça compte : 22 Go de VRAM à ce prix rend l’inférence de modèles 13B-27B quantifiés accessible sur du matériel d’occasion, sans passer par du cloud.
À retenir
- Apache 2 — licence sous laquelle Mojo publie son compilateur et sa toolchain [2]
- 52 — score de Qwen 3.8 27B, égal à GPT-5.6 Luna (max) [12]
- 282 dollars — prix pour passer une RTX 2080 Ti de 11 à 22 Go de VRAM [4]
🛠 Tuto du jour
Tuto / Outil : Aucun tuto d’installation locale identifié aujourd’hui.
💻 Matos & Infra local
Sujet Matos/Infra : Upgrade VRAM RTX 2080 Ti à 22 Go pour l’IA locale [4] Constat technique : Un atelier à Saitama remplace les puces GDDR6 d’origine par des modules Samsung 2 Go pour 282 dollars, portant la VRAM à 22 Go. Recommandation dev : Envisagez cette option pour étendre la capacité d’inférence locale à moindre coût. Sujet Matos/Infra : Inférence locale et efficacité MoE [13] Constat technique : FreeToken traite une machine personnelle comme une plateforme d’inférence élastique unifiée, avec une exécution adaptative à la bande passante pour le serving de modèles MoE. Recommandation dev : Évaluez FreeToken pour optimiser le serving de modèles MoE sur des machines sans infrastructure datacenter.
🎯 Fine-Tuning & Quantiz
Technique / Outil : Agentic ESOpt [9] Apport : Fine-tuning d’agents LLM long-horizon avec exigences GPU minimales, contournant la backpropagation lourde du RL [9]. Impact pratique : Permet d’affiner des modèles plus grands sur du matériel limité.
🧠 RAG & Agents Locaux
Architecture / Outil : FreeToken [13] Cas d’usage : Inférence de modèles MoE (Mixture of Experts) sur machine personnelle, sans datacenter [13]. Clé de voûte : Système de service edge-native avec exécution adaptative à la bande passante, traitant la machine comme une plateforme élastique [13].
📊 Track Record
Ce qu’on disait le 2026-08-05 : SQLite visé par des CVE « critiques » selon JFrog, mais l’analyse pointe un possible « LLM slop » [3]. Verdict aujourd’hui : en attente. Aucun élément du jour ne confirme ni n’infirme la réalité de ces CVE. Le débat reste ouvert, sans nouvelle preuve technique [1]-[18].
🔗 Sources (18) — vérifiées le 19/08/2026 05:00 UTC
- We Tracked a Shipment of Rare Books. It Ended at an Amazon AI Training Facility — Simon Willison · 2026-08-17
- Mojo🔥 is now open source — Simon Willison · 2026-08-18
- How Much Memory Does Your Agent Actually Need? — Hugging Face · 2026-08-18
- Un atelier japonais double la VRAM des RTX 2080 Ti pour pas cher — Korben · 2026-08-18
- Gadgetbridge - L’appli qui gère votre montre connectée sans Internet — Korben · 2026-08-18
- Agent Lightning v1.0: Towards Harnessed Agentic RL — HF Papers
- HarnessRisk: A Lifecycle-Oriented Benchmark for Agent Harness Safety — HF Papers
- AVA-Encoder: Towards Agent-Native Video Representation Learning — HF Papers
- Agentic ESOpt: Fine-Tuning Long-Horizon LLM Agents with Minimal GPU Requirements — HF Papers
- Policy-Invariant Reward Shaping from LLM Feedback: A Framework for Hybrid RL Agents — arXiv · 2026-08-18
- AI-Generated GitHub Copilot “Autofix” Allowed Compromise of Snowflake’s Jira — Hacker News · 2026-08-17
- Qwen 3.8 27B scores 52 on the Artificial Analysis Intelligence Index — Simon Willison · 2026-08-17
- FreeToken: Efficient Edge-Native MoE Serving with Bandwidth-Adaptive Execution — HF Papers
- aDSL: Agentic 3D Creation via Joint Agent-Program Design — HF Papers
- From Sequence to Structure: Relational Uncertainty Propagation for LLM Agents — HF Papers
- Dynamic Multi-Byte Prediction With Hierarchical Language Models — HF Papers
- Qwen3.8 27B scores 52 on Artificial Analysis — Hacker News · 2026-08-17
- On the Fragility of Self-Improving Agents: Variance, Task Order, and Underspecification — arXiv · 2026-08-18
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.