Partager ce rapport :
TL;DR
- Qwen 3.8 27B atteint 52 à l’Artificial Analysis Intelligence Index, score égal à GPT-5.6 Luna (max) [4]
- Des commandes massives de livres rares par des clients anonymes insensibles au prix aboutissent dans un centre d’entraînement IA d’Amazon [1]
- R^3-Bench montre que les LLM échouent au raisonnement sous budget partagé, contrairement aux budgets indépendants par tâche [3]
Les 3 signaux
🏆 Qwen 3.8 27B : un petit modèle qui égale les gros
 Qwen 3.8 27B, modèle Apache 2.0 de 27B paramètres avec vision, sort vendredi [6]. Score de 52 à l’Artificial Analysis Intelligence Index, identique à GPT-5.6 Luna (max), un point derrière GLM-5.2 (max, 753B) et DeepSeek V4 Pro 0813 (max, 1.6B) [4]. Taille de Luna inconnue mais « probablement bien plus grosse que 27B » [4]. Défaut identifié : le modèle « réfléchit excessivement » par défaut [6].
Pourquoi ça compte : un modèle de 27B tournant sur un laptop raisonnable rivalise avec des modèles de plusieurs centaines de milliards de paramètres, ce qui change le calcul coût/latence pour l’inférence locale.
📚 Des livres rares finissent dans un centre d’entraînement IA d’Amazon
 Enquête de 404 Media relayée par Simon Willison : des commandes de gros volumes de livres rares par des clients anonymes, apparemment insensibles au prix, aboutissent dans une installation d’entraînement IA d’Amazon [1]. Le phénomène était suspecté depuis un moment chez les libraires [1].
Pourquoi ça compte : si des données physiques non numérisées sont massivement collectées pour l’entraînement, les modèles futurs intègrent des contenus hors du périmètre des accords de licence classiques — un risque juridique et éthique à anticiper côté conformité.
🧠 Les LLM échouent au raisonnement sous budget partagé
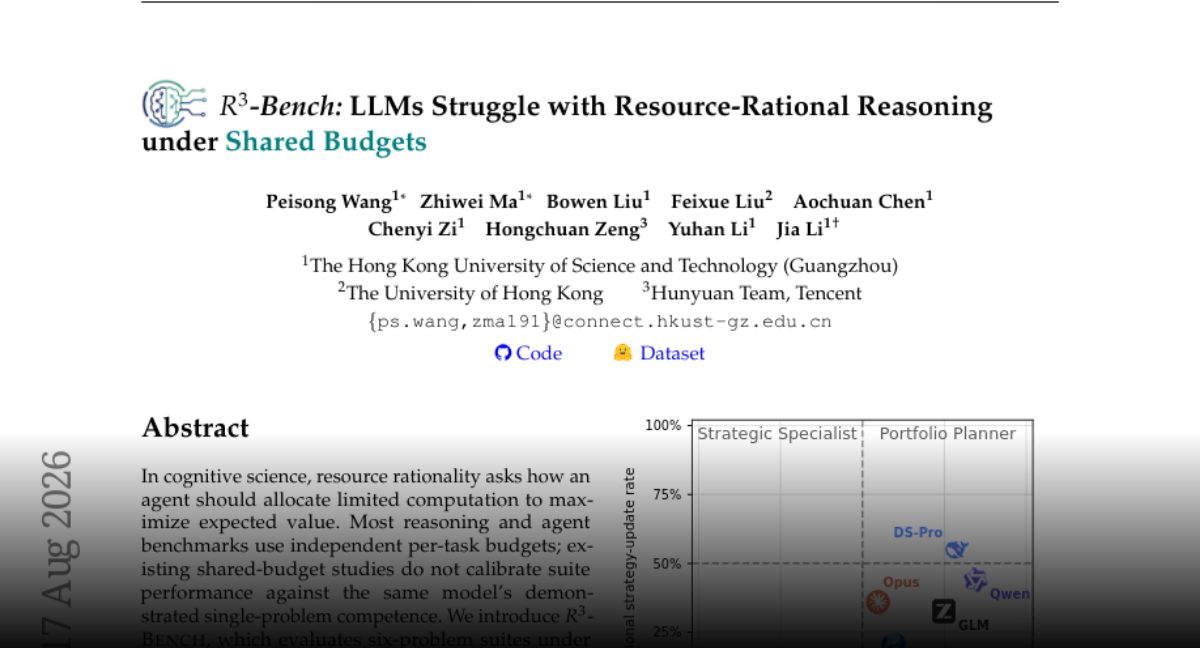 R^3-Bench, nouveau benchmark, teste le raisonnement « resource-rational » : comment un agent alloue un calcul limité pour maximiser la valeur attendue [3]. Les benchmarks existants utilisent des budgets indépendants par tâche ; les études à budget partagé ne calibrent pas la performance contre la compétence démontrée du même modèle sur problème unique [3]. Résultat : les LLM échouent [3].
Pourquoi ça compte : si tu conçois des agents avec un budget d’inférence global (coût, tokens), ce benchmark révèle que les modèles ne savent pas prioriser entre tâches — un facteur à intégrer dans la conception de ton orchestrateur.
À retenir
- 52 — score de Qwen 3.8 27B à l’Artificial Analysis Intelligence Index, égal à GPT-5.6 Luna (max) [4]
- 27B — paramètres de Qwen 3.8, taille adaptée à un laptop raisonnable, licence Apache 2.0 [6]
- ~90% — précision déjà atteinte par les modèles leaders sur Video-MME, rendant les benchmarks mon tour de vidéo obsolètes [2]
🛠 Tuto du jour
Tuto / Outil : Aucun tuto d’installation locale identifié aujourd’hui.
💻 Matos & Infra local
Sujet Matos/Infra : Qwen 3.8 27B, inférence locale sur laptop [4][6] Constat technique : Modèle 27B paramètres, licence Apache 2, adapté à un laptop raisonnablement équipé. Score de 52 à l’Artificial Analysis Intelligence Index, comparable à GPT-5.6 Luna, pourtant bien plus volumineux [4]. Défaut notable : sur-réflexion par défaut [6]. Recommandation dev : Tester ce checkpoint pour inférence locale quantifiée, en configurant explicitement le niveau de raisonnement pour éviter la surcharge de calcul [6].
🎯 Fine-Tuning & Quantiz
Technique / Outil : Qwen 3.8 27B, modèle Apache 2 de 27B paramètres [6] Apport : Score de 52 à l’Artificial Analysis Intelligence Index, égal à GPT-5.6 Luna (max) [4] Impact pratique : Taille adaptée à un laptop raisonnablement équipé, mais tendance à sur-réfléchir par défaut [6]
🧠 RAG & Agents Locaux
Architecture / Outil : Détection d’empoisonnement RAG par Attention Collapse [11]
Cas d’usage : Sécurisation de pipelines RAG locaux contre l’injection de documents adverses manipulant les réponses du LLM.
Clé de voûte : Analyse des signaux internes d’attention au niveau document, plutôt que les signaux de sortie (perplexité, cohérence), pour identifier les attaques.
📊 Track Record
Ce qu’on disait le 2026-08-04 : « Les LLM récompensent l’expertise métier, pas seulement la performance technique » [1] Verdict aujourd’hui : partiellement tenu. Le benchmark VideoGAIA [2] et R^3-Bench [3] confirment que les modèles plafonnent sur des tâches nécessitant une allocation de ressources et une compréhension contextuelle fines, au-delà de la simple performance brute. Cependant, Qwen 3.8 27B atteint un score d’intelligence index égal à GPT-5.6 Luna [4], suggérant que la performance technique reste un facteur dominant.
🔗 Sources (18) — vérifiées le 18/08/2026 05:00 UTC
- We Tracked a Shipment of Rare Books. It Ended at an Amazon AI Training Facility — Simon Willison · 2026-08-17
- VideoGAIA: A Benchmark for General AI Assistants on Agentic Video Understanding — HF Papers
- R^3-Bench: LLMs Struggle with Resource-Rational Reasoning under Shared Budgets — HF Papers
- Qwen 3.8 27B scores 52 on the Artificial Analysis Intelligence Index — Simon Willison · 2026-08-17
- Markdown SVG upgrades — Simon Willison · 2026-08-16
- Qwen 3.8 27B is excellent, but it defaults to wildly overthinking things — Simon Willison · 2026-08-16
- Quoting Dario Amodei — Simon Willison · 2026-08-16
- AnyTalk: Speech Animation for Arbitrary Characters Leveraging a Video Generation Model — HF Papers
- UI-Mate: Advancing Open-Weight Foundation GUI Agents with In-Context Demonstrations — HF Papers
- Position: AI Agents in Scientific Teams Should Be Studied as Human-Agent Systems — HF Papers
- When Context Bites: Detecting RAG Poisoning via Document-Level Attention Collapse — HF Papers
- Ventor-QTest: Threat-Model-Driven Verification of Vendor-Hosted LLM APIs — HF Papers
- ClawGym II: Exploring Black-Box RL on Agent Harness — HF Papers
- GenRouter: Unified Workflow Routing for Agentic Image Generation — HF Papers
- VibeWorlding: Can Multimodal Agents Construct 3D Open Worlds End-to-End? — HF Papers
- Understanding Cognition-Induced Risks in Agentic AI Systems — HF Papers
- Don’t Drop the BATON: Long-Horizon Robot Manipulation via Agentic Subtask Exploration and Transition-aware Memory — arXiv · 2026-08-17
- FlexWorm: Primitive-augmented Hybrid Contact-motion Planning for Suction-based Multi-segment Deformable Robots — arXiv · 2026-08-17
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.