Partager ce rapport :
TL;DR
- Qwen 3.8 27B sort sous licence Apache 2, mais sur-réfléchit par défaut [6]
- Simon Willison publie CORS Chat, UI web pour tester des endpoints compatibles OpenAI-Responses [1]
- Maglev introduit une architecture Transformer récurrente à mémoire fixe, parallélisable en entraînement [2]
Les 3 signaux
🚀 Qwen 3.8 27B : puissant mais bavard
 Qwen 3.8 27B est un LLM de 27B paramètres avec capacité vision, sous licence Apache 2, publié par le laboratoire Qwen d’Alibaba [6]. La taille 27B est adaptée pour tourner sur un laptop correctement équipé [6]. Le problème : le modèle « sur-réfléchit » par défaut, produisant des chaînes de raisonnement excessives [6]. Simon Willison l’a testé via LM Studio sur son M5 MacBook Pro et un NVIDIA DGX Spark [1].
Pourquoi ça compte : alternative open-source viable pour de l’inférence locale, mais vous devrez probablement ajuster les paramètres de raisonnement pour éviter une latence inutile en production.
🧠 Maglev : mémoire récurrente glissante
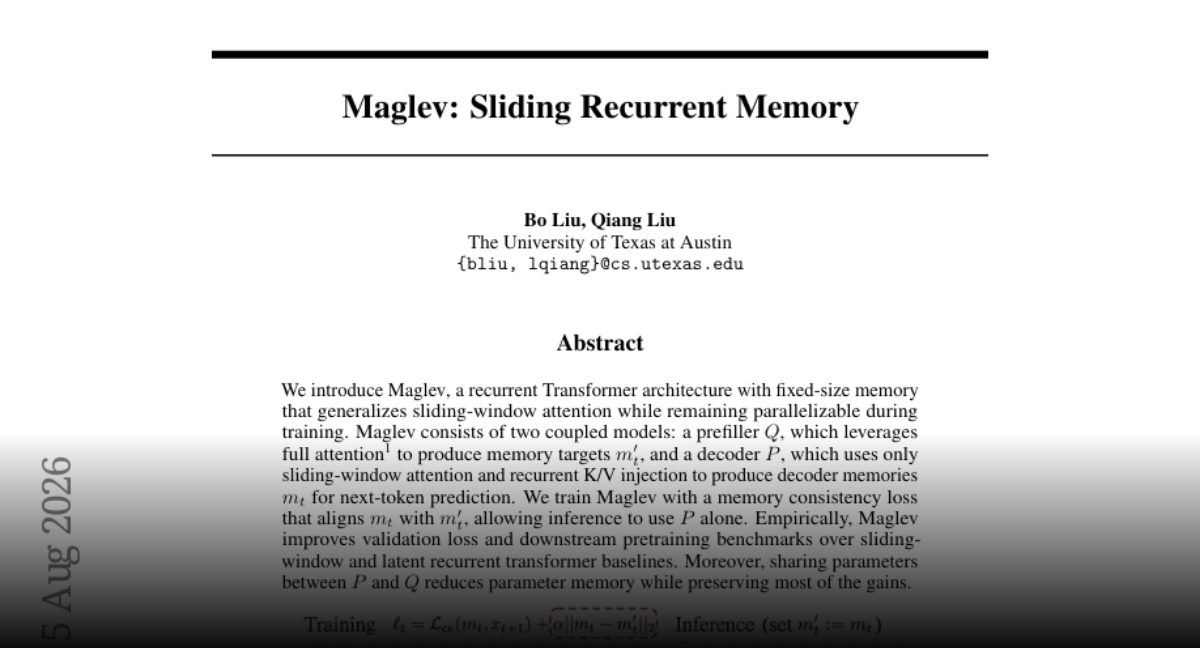 Maglev est une architecture Transformer récurrente avec mémoire de taille fixe qui généralise l’attention à fenêtre glissante tout en restant parallélisable en entraînement [2]. Elle combine deux modèles couplés : un pré-remplisseur Q utilisant une attention complète, avec une alternance d’attention pleine et fenêtrée en pratique [2].
Pourquoi ça compte : si cette architecture tient ses promesses, elle permet de traiter des séquences longues avec un coût mémoire borné, sans sacrifier la parallélisation à l’entraînement.
🛠️ CORS Chat : outil de test pour endpoints compatibles OpenAI
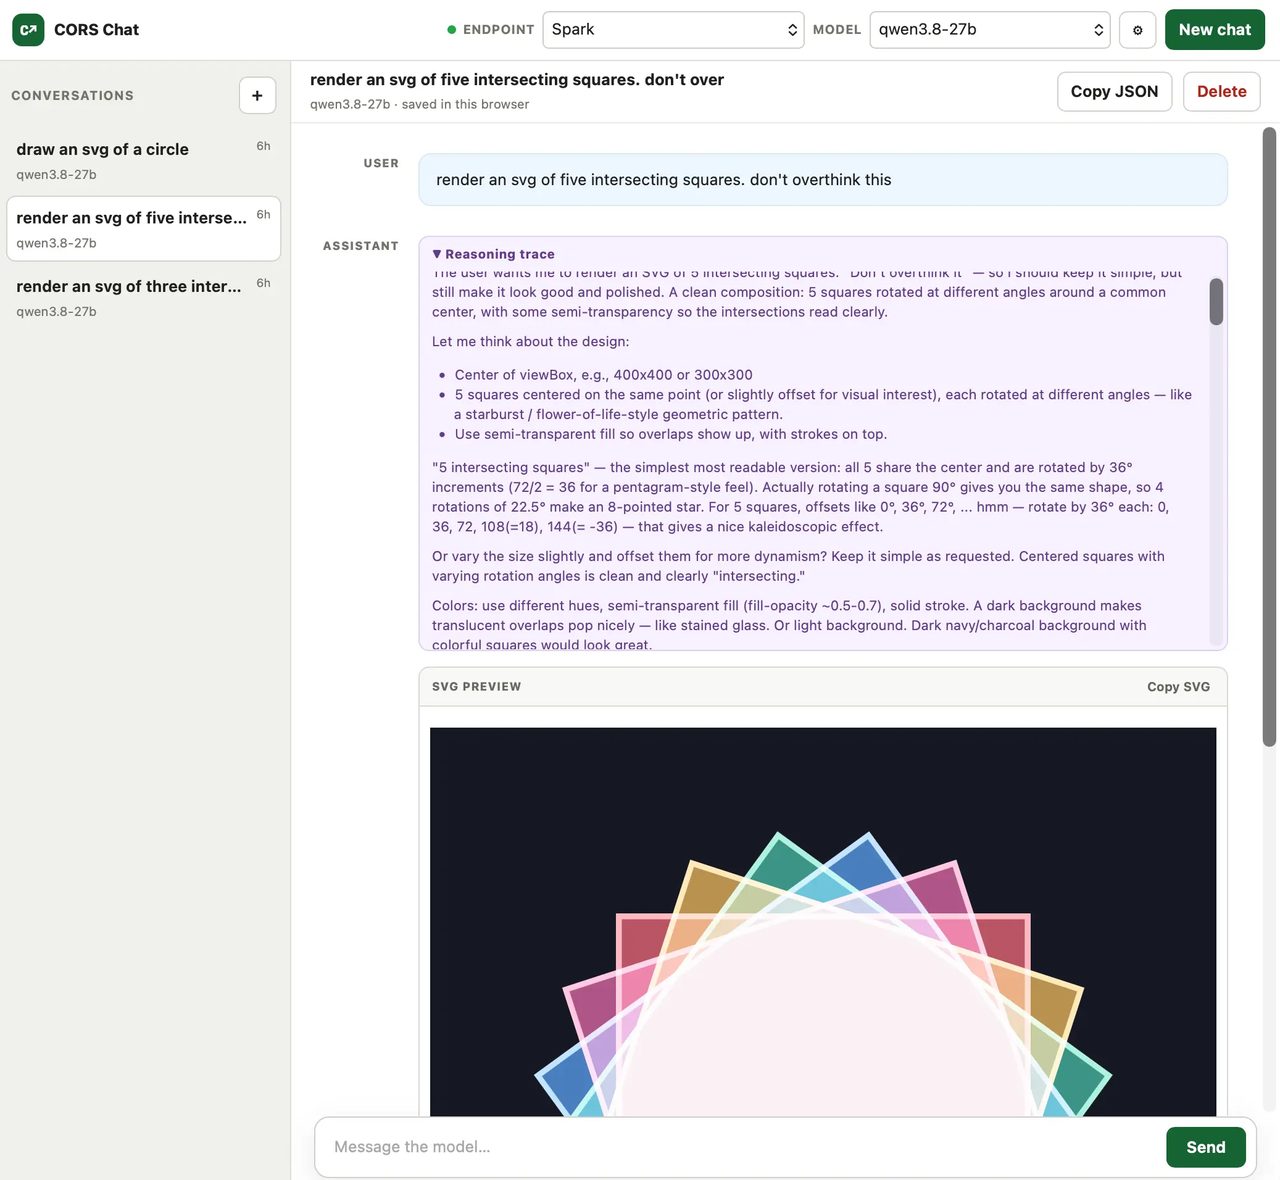 Simon Willison a construit CORS Chat en une journée avec GPT-5.6-Sol xhigh [1]. L’outil fournit une UI web pour exercer un endpoint de chat compatible OpenAI-Responses [1]. Il l’a testé contre LM Studio avec l’option
--cors et contre OpenRouter [1].
Pourquoi ça compte : si vous développez avec des modèles locaux ou via des proxies, cet outil simplifie le test d’interopérabilité des endpoints sans écrire de client custom.
À retenir
- 27B paramètres pour Qwen 3.8, sous licence Apache 2, avec capacité vision [6]
- 2 modèles couplés dans Maglev : un pré-remplisseur Q et un modèle récurrent à mémoire fixe [2]
- 1 journée de développement pour CORS Chat, construit avec GPT-5.6-Sol xhigh [1]
🛠 Tuto du jour
Tuto / Outil : CORS Chat [1] Ce qu’on installe : Une interface web pour tester un endpoint chat compatible OpenAI-Responses, utilisée avec Qwen 3.8 27B sous LM Studio. Prérequis hardware & commande : M5 MacBook Pro ou NVIDIA DGX Spark ; lancement de LM Studio avec l’option
--cors[1].
💻 Matos & Infra local
Sujet Matos/Infra : Qwen 3.8 27B sur Mac M5 et DGX Spark [1][6] Constat technique : Simon Willison teste Qwen 3.8 27B (Apache 2, vision) sur MacBook Pro M5 et NVIDIA DGX Spark via LM Studio. Il juge 27B comme une taille idéale pour un laptop raisonnablement équipé, mais note un défaut de “sur-réflexion” par défaut [6]. Recommandation dev : Prévoir une configuration de température ou un prompt système limitant la longueur des raisonnements pour ce modèle.
🎯 Fine-Tuning & Quantiz
Technique / Outil : Approximate Muon with low-rank adapters [16] Apport : Rend le combinaison de l’optimiseur Muon avec LoRA mathématiquement possible pour le fine-tuning paramétrique efficace (PEFT) [16]. Impact pratique : Permet d’appliquer les bénéfices de Muon aux méthodes PEFT, domaine où son usage était limité [16].
Technique / Outil : Rollplex [15] Apport : Partage spatial GPU inter-phase pour le post-entraînement RL des VLM, réduisant la sérialisation stricte des phases [15]. Impact pratique : Améliore l’efficacité des runtimes RL on-policy pour les modèles de vision-langage [15].
🧠 RAG & Agents Locaux
Architecture / Outil : CORS Chat [1] Cas d’usage : Interface web pour tester un endpoint de chat compatible OpenAI-Responses contre Qwen 3.8 27B exécuté localement via LM Studio [1]. Clé de voûte : Utilise l’option
--corsde LM Studio pour autoriser les requêtes du navigateur vers le modèle local [1].
📊 Track Record
Ce qu’on disait le 2026-08-03 : β-OPSD identifie l’instabilité de l’auto-distillation on-policy comme un cas limite β=1 d’une famille plus large [11] Verdict aujourd’hui : en attente. Le papier “Latent On-Policy Self-Distillation” [8] propose une méthode alternative sans référence explicite à β-OPSD, mais confirme l’intérêt pour ce champ. Aucun élément ne valide ou infirme la caractérisation théorique de β-OPSD.
🔗 Sources (18) — vérifiées le 17/08/2026 05:00 UTC
- CORS Chat — Simon Willison · 2026-08-15
- Maglev: Sliding Recurrent Memory — HF Papers
- Expected Free Energy-based Informative Path Planning for Robotic Mars Exploration — arXiv · 2026-08-14
- SheetCompass: Hierarchical Relation Graphs for Agentic Spreadsheet Reasoning — arXiv · 2026-08-14
- Markdown SVG upgrades — Simon Willison · 2026-08-16
- Qwen 3.8 27B is excellent, but it defaults to wildly overthinking things — Simon Willison · 2026-08-16
- Quoting Dario Amodei — Simon Willison · 2026-08-16
- Latent On-Policy Self-Distillation — HF Papers
- MobileMem: Learning from a Year of Mobile Experiences — HF Papers
- Generation as Auxiliary Supervision: Enhancing Visual Understanding at Zero Inference Overhead via Decoupled Embedding Prediction — HF Papers
- RibAssist 3D: Biplanar Rib-Fracture Detection, Addressing, and Selective 3D Localization from CT-Derived Projections — HF Papers
- Patterns and problems in emerging multi-agent systems — Hacker News · 2026-08-16
- Handover of In-Context Learning State Across Session Boundaries — arXiv · 2026-08-14
- Universal Thermodynamic Interatomic Potentials for Crystalline Materials — arXiv · 2026-08-14
- Rollplex: Cross-Phase GPU Spatial Sharing for Vision Language Model Post-Training — arXiv · 2026-08-14
- Approximate Muon with low-rank adapters — arXiv · 2026-08-14
- Twin: Playing an Unknown Game with a Test-Time Digital Twin — arXiv · 2026-08-14
- THRIVE: Therapeutic Humanoid Robot In Virtual Environment — arXiv · 2026-08-14
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.