TL;DR
Les 3 signaux
🧠 Inférence
AMD grave les modèles dans le silicium
 AMD rachète Taalas, startup spécialisée dans l’« etching » de modèles d’IA directement dans le silicium pour accélérer l’inférence 1. L’opération est relayée par The Register, avec 896 points et 671 commentaires sur Hacker News 1. Aucun montant ni calendrier n’est divulgué dans les éléments fournis. L’approche consiste à figer des modèles spécifiques en circuits matériels dédiés, ce qui élimine la couche d’exécution logicielle classique.
🤖 Agents
la supervision humaine échoue 1 fois sur 3
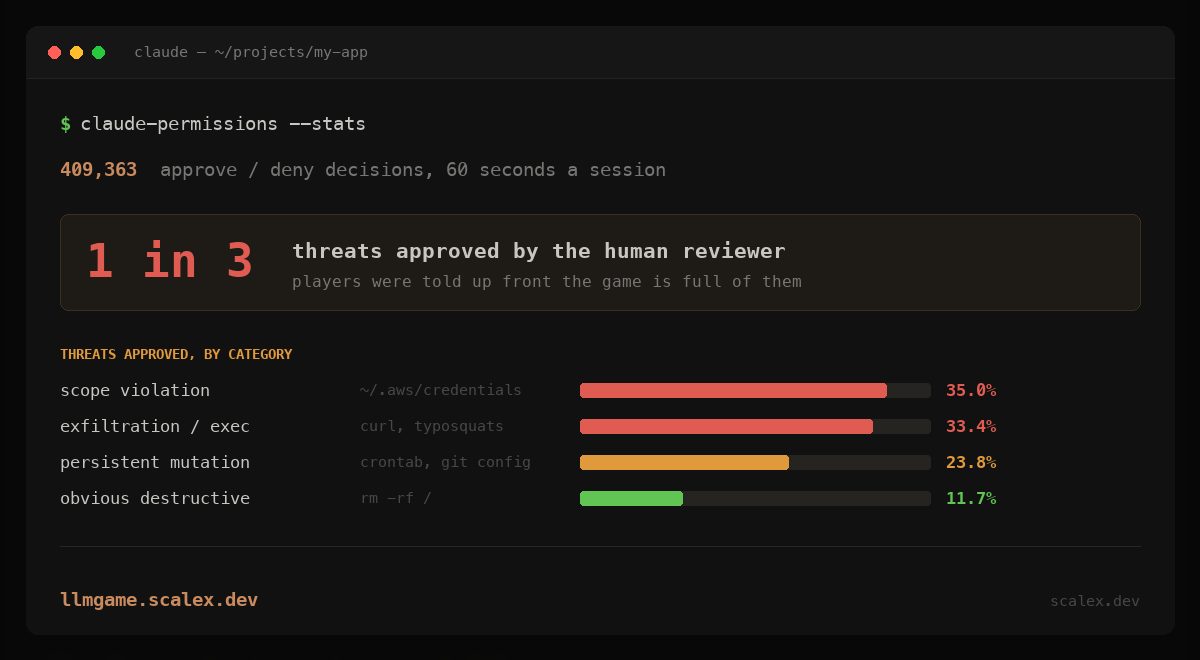 Sur 40 000 exécutions de jeux, les humains chargés d’approuver les commandes d’agents IA ont manqué 1 menace sur 3 3. Le chiffre vient de scalex.dev, relayé sur Hacker News avec 331 points 3. Aucune ventilation par type de menace ou par contexte n’est fournie. Parallèlement, Qwen3.8 Max est classé meilleur modèle global selon l’agentic index d’Artificial Analysis 2, et Cloudflare publie Kitesurf, un navigateur « agent-first » qui exécute les agents dans des isolates V8 5.
📉 Recherche
les modèles vidéo échouent sur la comptabilité d’événements
 Les Video Language Models (VLM) ratent des tâches simples de suivi d’événements (nombre, taux, durée) dans des benchmarks réels, car les clips fixes emmêlent ces variables 7. Le papier arXiv 2608.06361 propose des benchmarks programmatiques qui auditent les événements rapportés plutôt que de scorer uniquement la réponse finale 7. Par ailleurs, un survey sur l’apprentissage robotique oppose deux approches : des politiques qui figent la compétence dans les poids (modèles VLA) versus des agents qui écrivent leurs propres compétences en code 15.
À retenir
- 1sur 3 — taux de menaces manquées par les humains en validant des commandes d’agents IA sur 40 000 parties 3
- 3.8Qwen3.8 Max — meilleur modèle global selon l’agentic index d’Artificial Analysis 2
- 8V8 isolates — Kitesurf de Cloudflare exécute les agents dans des isolates V8, approche navigateur « agent-first » 5
Radar Contradictions
Claim : Qwen3.8 Max est classé meilleur modèle global selon l’agentic index 2. Contre-signal : Le papier arXiv 7 montre que les benchmarks vidéo réels, souvent utilisés pour évaluer les modèles, échouent à isoler les modes de défaillance, et que les benchmarks programmatiques ne notent que la réponse finale sans auditer les événements rapportés. Cette critique méthodologique s’applique potentiellement à la robustesse de l’indice cité. Ce que ça change pour un dev : Un classement “agentic” ne garantit pas la fiabilité des modèles sur des tâches de bookkeeping d’événements simples.
Reproduit en 15 min
Repo/Snippet : TutorMoments 6 Comment tester : Lire le dataset sur la page Hugging Face, charger un échantillon, et exécuter une inférence sur un petit LLM pour vérifier si le modèle identifie les moments d’intervention vs. non-intervention. Prérequis : Python, accès Hugging Face, GPU optionnel.
Track Record
Partiellement tenu
Ce qu’on disait le 2026-07-23 : « Kimi K3 est compétitif avec Fable ; les deux modèles sont SoTA 2 » Verdict aujourd’hui : partiellement tenu. Le classement a évolué : Qwen3.8 Max est désormais le meilleur modèle global selon l’agentic index 2. La position de Kimi K3 et Fable n’est pas confirmée par les éléments du jour.
Ce qu’on disait le 2026-07-23 : « OpenAI sort Presence, plateforme enterprise pour agents vocaux et chat 5 » Verdict aujourd’hui : en attente. Aucun élément récent ne permet de vérifier l’adoption ou la performance de Presence. Le débat actuel porte sur la supervision humaine des agents, avec 1 menace sur 3 non détectée 3.
Sous le radar
L’item : 17 Activity Frames: Deterministic Screen-Activity Compilation for Agent Memory and Replay — https://huggingface.co/papers/2608.05784 (métrique faible: non listée) Pourquoi c’est du signal : Propose une alternative déterministe et sans modèle aux pipelines d’inférence coûteux pour la mémoire des agents, ciblant un angle mort concret (l’action vs la parole) que les benchmarks dominants ignorent.
Donnée manquante
L’annonce : Qwen3.8 Max now ranked as the best overall model by agentic index 2 Ce qui manque : Les conditions exactes du benchmark (taille du dataset, coût d’inférence, reproductibilité) ne sont pas divulguées dans le titre ou le résumé. Pourquoi ça compte : Sans ces données, le classement ne peut être vérifié ni comparé de manière fiable à d’autres modèles, faussant l’évaluation réelle de la performance.
Sources (18) — vérifiées le 08/08/2026 05:00 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | AMD acquires Taalas to boost inference performance by etching models in silicon | Hacker News | 6 août 2026 |
| 2 | Qwen3.8 Max now ranked as the best overall model by agentic index | Hacker News | 6 août 2026 |
| 3 | Humans missed 1 in 3 threats approving AI agent commands across 40k game runs | Hacker News | 6 août 2026 |
| 5 | Kitesurf: Agent-first browser that runs in V8 isolates | Hacker News | 7 août 2026 |
| 6 | TutorMoments: Do AI tutors know when to help and when to hold back? | Hugging Face | 7 août 2026 |
| 7 | The Low Frequency Trap: Video Language Models Fail at Simple Event Bookkeeping | arXiv | 6 août 2026 |
| 15 | Weights or Skills? A Survey of Robot-Learning Techniques: from Action-Predicting Weights to Robots that Write their Own Skills | HF Papers | |
| 17 | Activity Frames: Deterministic Screen-Activity Compilation for Agent Memory and Replay | HF Papers |
Autres lectures (10)
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.