TL;DR
- TokTier propose une tokenization stateful exacte pour éviter la re-tokenisation complète des transcripts d’agents à chaque appel 1
- ExtractBench sort un benchmark d’extraction documentaire guidée par schéma avec preuves sources 2
- β-OPSD identifie l’instabilité de l’auto-distillation on-policy comme un cas limite β=1 d’une famille plus large 11
Les 3 signaux
⚡ Coût caché de la tokenization dans le serving d’agents
 Les systèmes de serving LLM cachent l’état KV des prompts, mais la plupart des front-ends re-tokenisent l’intégralité du texte à chaque appel 1. Le coût retombe sur les agents de codage, qui resoumettent un long transcript après chaque petit résultat d’outil 1. La réutilisation est difficile car même un court append peut changer les frontières de tokens près de la fin de la séquence précédente 1. TokTier adresse ce problème avec une tokenization stateful exacte 1.
📊 Benchmarks
extraction documentaire et optimisation d’hyperparamètres
 ExtractBench évalue les agents sur l’extraction guidée par schéma : le modèle suit un schéma utilisateur et produit la sortie avec des preuves sources comme métadonnées de grounding 2. AgentHPOBench évalue les LLM comme optimiseurs séquentiels d’hyperparamètres, là où les benchmarks existants se limitent à la génération de code statique ou à la correction de réponses finales 4.
🔧 Instabilité de l’auto-distillation on-policy identifiée
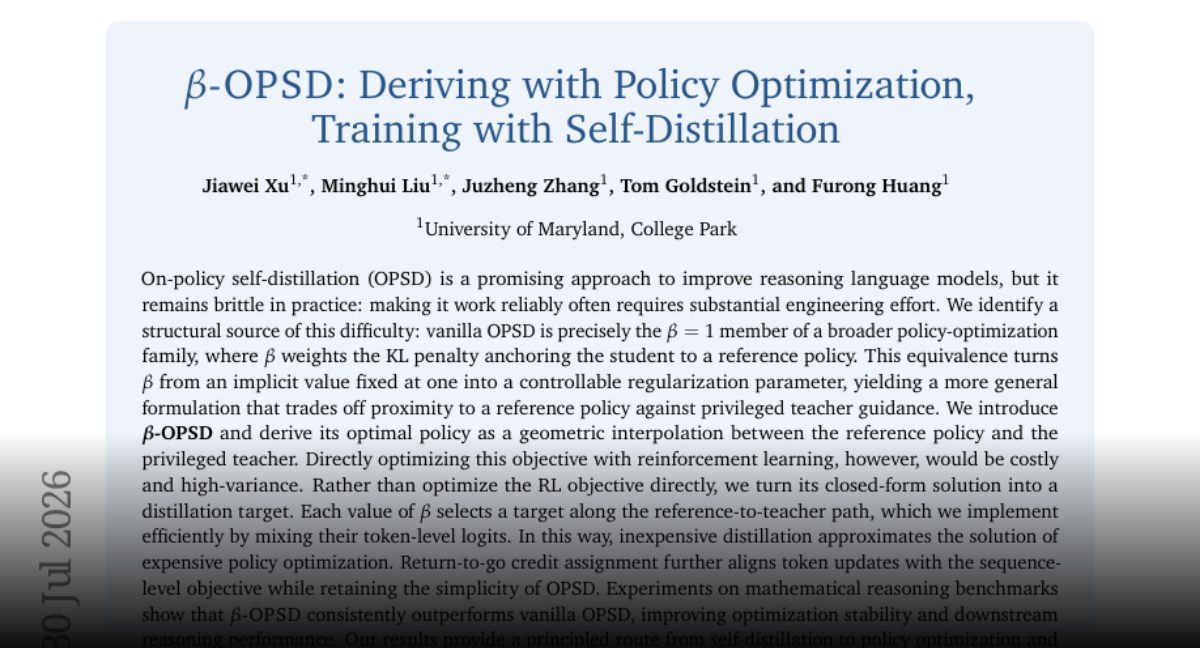 L’auto-distillation on-policy (OPSD) améliore les modèles de raisonnement mais reste fragile en pratique 11. β-OPSD démontre que l’OPSD vanilla est précisément le membre β=1 d’une famille plus large d’optimisation de politique 11. Cette reformulation structurelle explique la difficulté de réglage et ouvre une voie plus stable 11.
À retenir
- Re-tokenisation complète à chaque appel — le serving d’agents paie un coût évitable que TokTier élimine avec une tokenization stateful exacte 1
- 1β=1 — l’OPSD vanilla est un cas limite d’une famille plus large ; le cadre β-OPSD stabilise l’entraînement par auto-distillation 11
- Preuves sources obligatoires — ExtractBench exige un grounding métadonné pour l’extraction guidée par schéma, un critère de qualité directement applicable 2
Radar Contradictions
Claim : Les agents Deep Research sont fiables dans des environnements informationnels ouverts. 15 Contre-signal : L’étude montre que des connaissances trompeuses mais crédibles induisent des conclusions fausses, remettant en cause cette fiabilité. 15 Ce que ça change pour un dev : Ne pas déployer un agent de recherche sans garde-fou contre les sources trompeuses.
Reproduit en 15 min
Repo/Snippet : Mu – Tools for Agents 17 Comment tester : Clonez le repo, lancez l’outil principal sur un exemple d’agent fourni dans la documentation, puis exécutez un test d’intégration basique. Prérequis : Go, aucun GPU ni API key. Références : 17
Track Record
Partiellement tenu
Ce qu’on disait le 2026-07-20 : Xiaomi publie Xiaomi-Robotics-1, un modèle VLA entraîné sur plus de 100 000 heures de trajectoires réelles 12 Verdict aujourd’hui : partiellement tenu. La dynamique VLA reste forte, mais aucun élément du jour ne confirme directement les performances de Xiaomi-Robotics-1. Les publications actuelles se concentrent sur l’efficacité temporelle (FibVLA 9) et le RL post-entraînement (WCM 6), sans mention de Xiaomi. En attente de benchmarks comparatifs.
Sous le radar
L’item : TokTier: Exact Stateful Tokenization for Agentic LLM Serving 1 — arXiv, faible visibilité (aucune citation signalée) Pourquoi c’est du signal : Adresse un coût réel et sous-estimé des agents de code : la re-tokenisation intégrale du transcript à chaque appel. La gestion fine des frontières de tokens après append court est un problème d’ingénierie précis, ignoré par les benchmarks et les papiers “agents” plus visibles.
Donnée manquante
L’annonce : Sprocket, « The Best AI Agent for Hardware and Software Development » 16 Ce qui manque : Aucun chiffre de coût d’inférence, de latence ou de taux de réussite n’est fourni dans l’annonce. Pourquoi ça compte : Sans métrique de performance ou de coût, le titre « Best » est invérifiable. L’évaluation réelle d’un agent de développement exige des benchmarks reproductibles ou des données de coût opérationnel, absents ici.
Sources (18) — vérifiées le 03/08/2026 05:00 UTC
| N° | Publication | Site | Date |
|---|---|---|---|
| 1 | TokTier: Exact Stateful Tokenization for Agentic LLM Serving | arXiv | 31 juillet 2026 |
| 2 | ExtractBench: A Benchmark for Schema-Guided Enterprise Document Extraction | arXiv | 31 juillet 2026 |
| 4 | AgentHPOBench: A Benchmark For Evaluating LLM Agents as Sequential Hyperparameter Optimizers | arXiv | 31 juillet 2026 |
| 6 | WCM: A World Critic Model for Vision-Language-Action Reinforcement Learning | arXiv | 31 juillet 2026 |
| 9 | FibVLA: An Efficient Temporal Vision-Language-Action Model with Fibonacci Sampling | arXiv | 31 juillet 2026 |
| 11 | β-OPSD: Deriving with Policy Optimization, Training with Self-Distillation | HF Papers | |
| 12 | Σ-Mem: An Online Reliability Memory for LLM-based Multi-Agent Systems | HF Papers | |
| 15 | Is Deep Research Reliable? Misleading Knowledge Induces False Conclusions | HF Papers | |
| 16 | Show HN: Sprocket – The Best AI Agent for Hardware and Software Development | Hacker News | 2 août 2026 |
| 17 | Show HN: Mu – Tools for Agents | Hacker News | 2 août 2026 |
Autres lectures (8)
V3ille — Sources : arXiv, GitHub Trending, Hugging Face Daily Papers, OpenAI, DeepMind, Google AI, IEEE Spectrum, The Robot Report.